Guide des prompts OpenAI GPT-5.5 : Tutoriel étape par étape
Prérequis
Avant de commencer, assurez-vous d'avoir :
- Une clé API OpenAI avec accès à
gpt-5.5(inscrivez-vous sur platform.openai.com si nécessaire). - Python 3.10+ installé.
- La dernière SDK OpenAI pour Python : exécutez
pip install openai. - Une connaissance basique de l'API (chat completions ou API Responses).
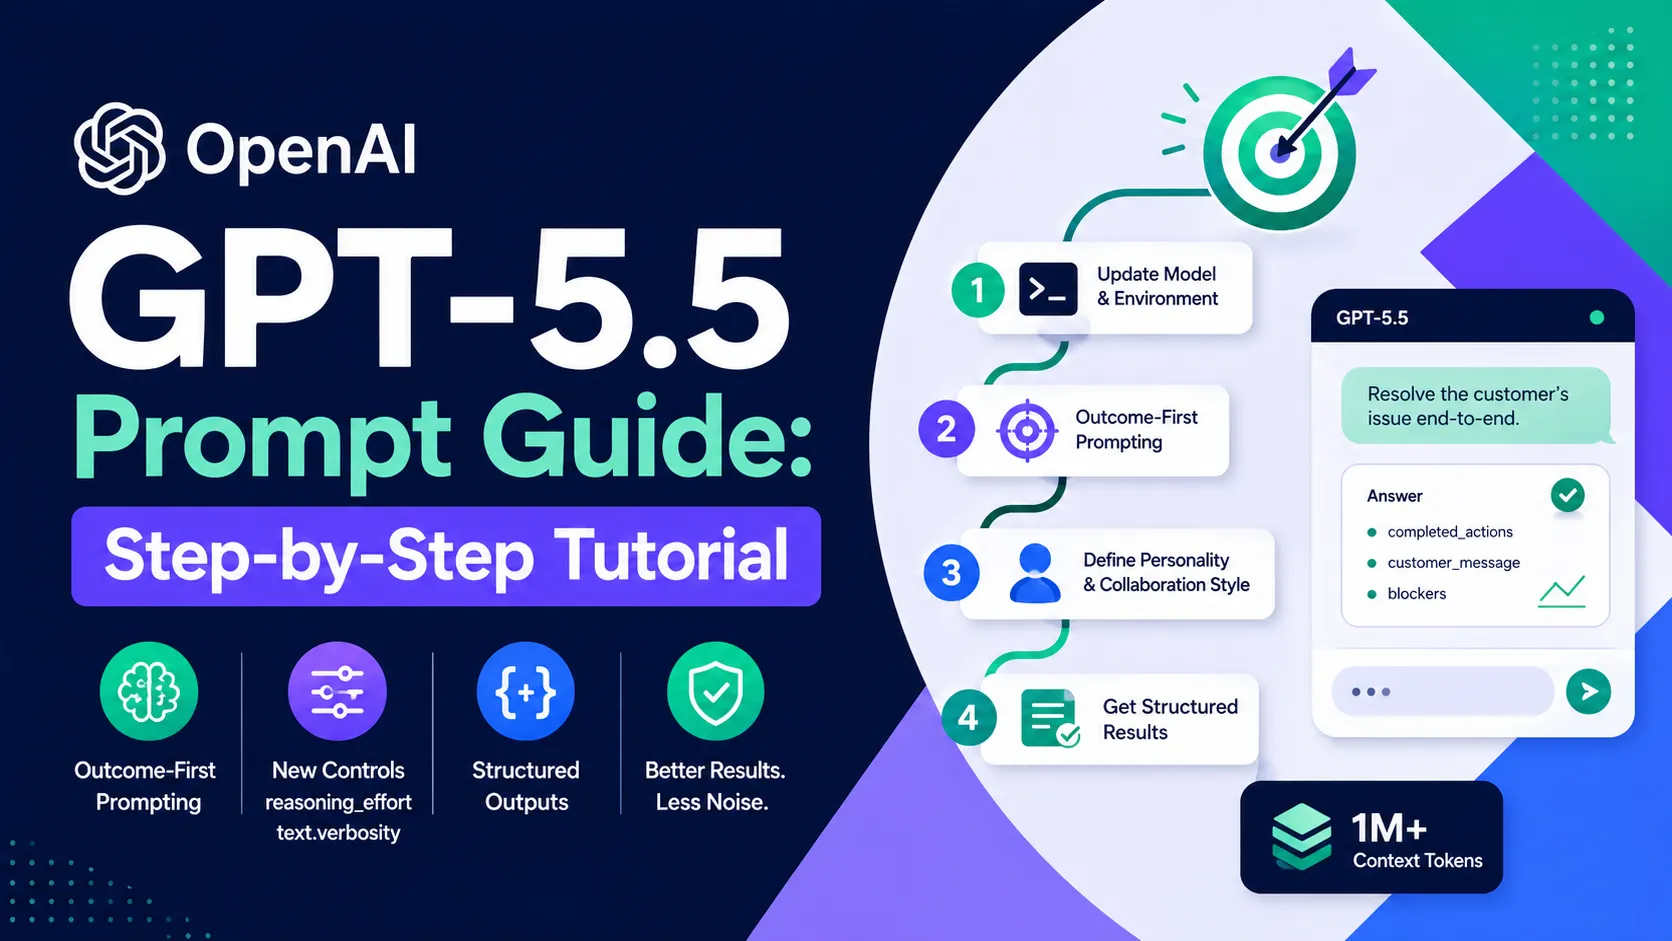
GPT-5.5 est disponible dans l'API et supporte jusqu'à 1M+ tokens de contexte, des sorties structurées et de nouveaux contrôles comme reasoning_effort et text.verbosity.
Étape 1 : Mettez à jour votre modèle et votre environnement
Changez vers gpt-5.5 et configurez un client basique. Les prompts legacy de GPT-5 ou précédents sont souvent moins performants — commencez avec des prompts nouveaux.
pip install --upgrade openai
from openai import OpenAI
client = OpenAI(api_key="your-api-key-here")

response = client.chat.completions.create(
    model="gpt-5.5",
    messages=[{"role": "user", "content": "Test prompt"}]
)
print(response.choices[0].message.content)
Sortie attendue : Une réponse concise et directe. Pas de superflu.
Étape 2 : Apprenez le principe fondamental – Prompting centré sur le résultat
GPT-5.5 excelle lorsque vous décrire le résultat souhaité, les critères de succès, les contraintes et les éléments de preuve disponibles — puis laissez le modèle choisir le chemin. Éliminez les longues chaînes étape par étape.
Mauvais (style legacy) :
Premièrement lire la politique, ensuite vérifier les données du compte, puis comparer les champs, puis décider...
Bon (style GPT-5.5) :
Resolvez la requête du client de bout en bout.

Le succès signifie :
- La décision d'éligibilité utilise uniquement la politique et les données du compte disponibles
- Tout action autorisée se termine avant de répondre
- La réponse finale inclut : completed_actions, customer_message, blockers
- Si des éléments de preuve manquent, demandez le champ minimal nécessaire
Testez ce pattern immédiatement — cela réduit le superflu et augmente la précision.
Étape 3 : Définissez la personnalité et le style de collaboration
GPT-5.5 est par défaut efficace et orienté vers la tâche. Pour les applications conversationnelles, ajoutez des blocs de personnalité courts.
# Personnalité
Vous êtes un collaborateur compétent : abordable, stable et direct. Assumez que l'utilisateur est compétent. Restez concis sans être abrupt. Adaptez votre ton à celui de l'utilisateur dans des limites professionnelles.
Insérez cela au début de votre prompt système. Limitez-le à 150 mots. Pour des assistants expressifs, ajoutez explicitement de la bienveillance ou de la curiosité.
Étape 4 : Ajoutez des préambules pour une meilleure expérience utilisateur
Pour les tâches multi-étapes ou utilisant des outils, indiquez au modèle d'envoyer une courte mise à jour visible d'abord :
Avant toute utilisation d'outils pour une tâche multi-étapes, envoyez une courte mise à jour visible pour l'utilisateur qui reconnaît la demande et indique la première étape. Limitez-la à une ou deux phrases.
Ceci améliore la vitesse perçue dans les applications de streaming. Combine avec l'API Responses pour les workflows avec état.
Étape 5 : Exploiter les nouveaux paramètres pour le contrôle
Utilisez-les dans vos requêtes API :
reasoning_effort:none(plus rapide),low,medium(défaut),high,xhigh.text.verbosity:lowpour une réponse concise,medium(défaut) pour un équilibre.
Exemple de code :
from openai import OpenAI
client = OpenAI()

response = client.chat.completions.create(
    model="gpt-5.5",
    messages=[{
        "role": "system",
        "content": "Vous êtes un assistant de codage utile."
    }, {
        "role": "user",
        "content": "Implémentez une fonction Fibonacci rapide en Python."
    }],
    reasoning_effort="low",      # Plus rapide pour les tâches simples
    temperature=0.7,
    max_tokens=500
)
print(response.choices[0].message.content)
Comportement attendu : Code plus court, direct, avec des explications minimales, sauf si vous définissez une verbosité plus élevée.
Étape 6 : Ajouter des conditions d'arrêt et des règles d'évidence
Empêchez la réflexion excessive avec des règles d'arrêt explicites :
Resolvez dans le minimum d'étapes utiles.
Après chaque résultat d'outil, demandez : "Est-ce que je peux répondre à la demande principale maintenant avec des preuves ?" Si oui, produisez la réponse finale immédiatement.
Utilisez la quantité minimale de preuves suffisante ; citez précisément.
Ceci est crucial pour les agents ou les tâches de longue durée.
Étape 7 : Tester, itérer et utiliser les sorties structurées
Évaluez toujours :
- Exécutez 10 requêtes représentatives avec le style ancien versus nouveau.
- Mesurez la qualité de la réponse, l'utilisation de tokens et la latence.
- Préférez
response_format={ "type": "json_schema", ... }plutôt que les JSON décrits dans la requête pour garantir la structure.
Exemple de requête avec sortie structurée :
response = client.responses.create(
    model="gpt-5.5",
    input="Extrayez le nom et l'e-mail de ce texte : ...",
    text_format={"type": "json_schema", "schema": {...}}
)
Problèmes courants & dépannage
- Des résultats moins bons que GPT-5 ? Votre ancienne requête est trop détaillée. Supprimez les étapes du processus et conservez uniquement les résultats.
- Réflexion excessive / latence élevée ? Réduisez
reasoning_effortàlowet renforcez les conditions d'arrêt. - Réponses trop courtes ? Réglez
text.verbosity: "medium"ou ajoutez "expliquez votre raisonnement rapidement". - Les appel d'outils échouent ? Déplacez les directives dans les descriptions des outils, pas dans la requête principale.
- Problèmes de conscience de la date ? Supprimez toutes les lignes "date actuelle"—GPT-5.5 connaît UTC par défaut.
Exécutez des évaluations sur un petit ensemble de tests avant le lancement en production.
Étapes suivantes
- Explorez le guide officiel complet dans votre tableau de bord OpenAI.
- Essayez la compétence de migration Codex :
$openai-docs migrate this project to gpt-5.5. - Construisez un petit agent utilisant l'API Responses et testez les préambules + personnalité.
- Surveillez les coûts de tokens—GPT-5.5 récompense les requêtes minimales.
Appliquez ces modèles aujourd'hui et observez vos workflows devenir plus rapides, moins coûteux et plus fiables.
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
PaidSync.ai
MCP ServersPaidSync.ai is a hosted MCP server for paid advertising that exposes 610+ tools across 14 advertising, analytics, tagging, and commerce platforms. It supports read/write workflows from AI clients including ChatGPT, Claude, Gemini, Cursor, Claude Code, and Codex, with a free plan.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.