OmniShow क्या है? मानव-वस्तु इंटरैक्शन वीडियो जेनरेशन को क्रांतिकारी बनाने वाला AI फ्रेमवर्क
मुख्य बातें
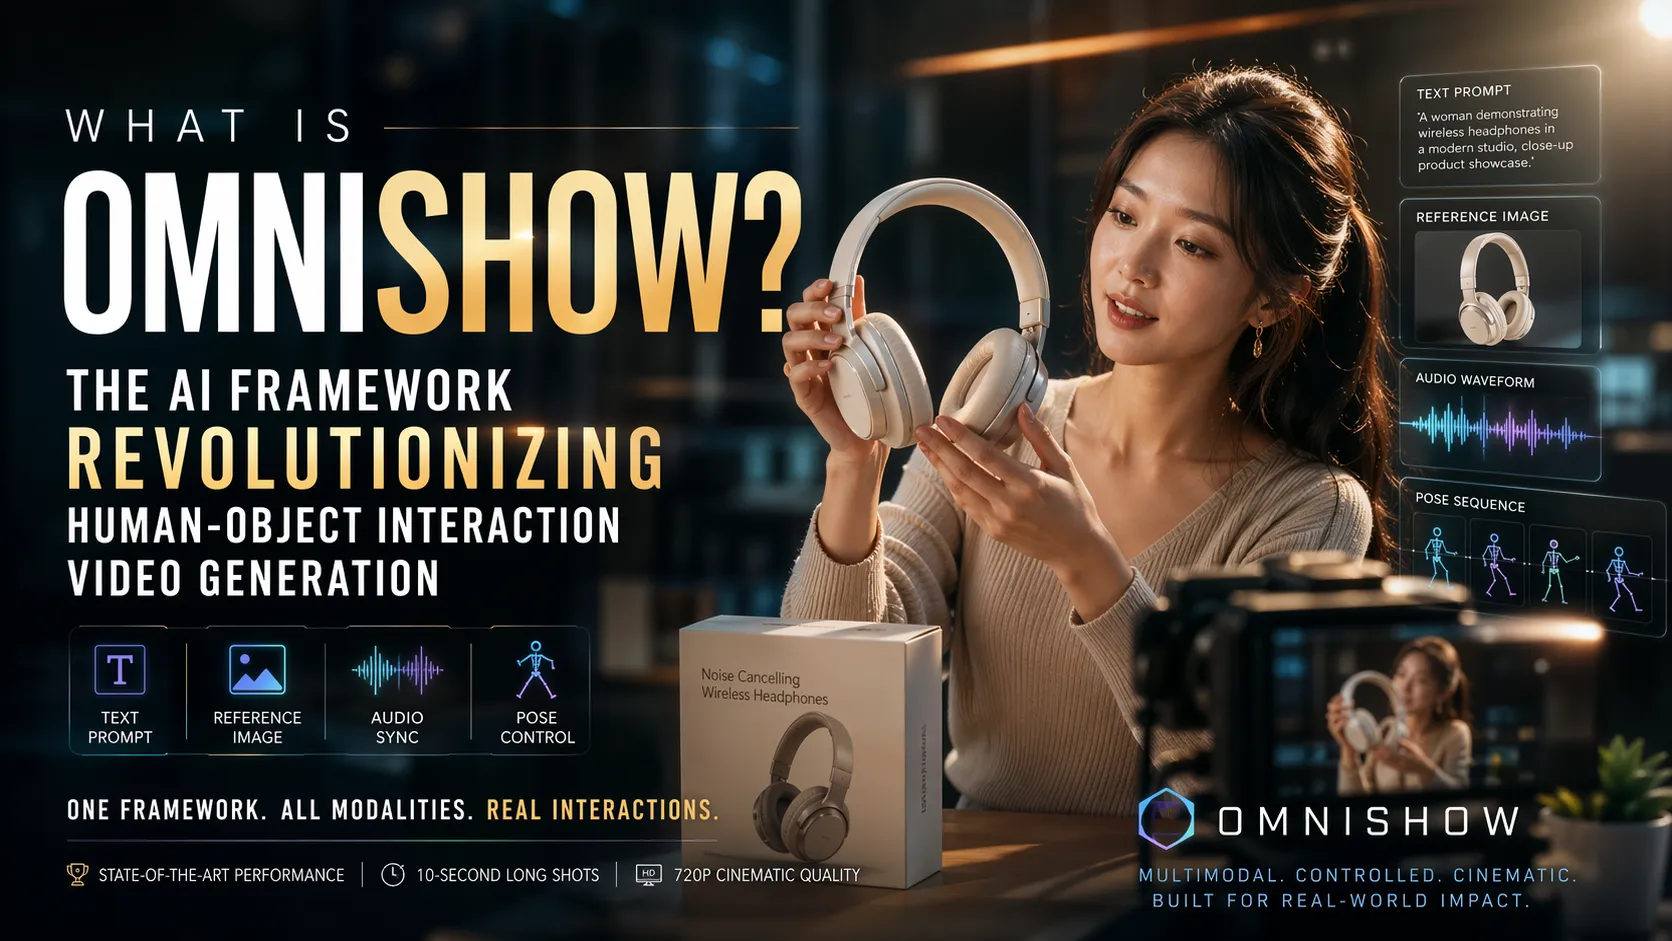
- OmniShow मानव-वस्तु इंटरैक्शन वीडियो जेनरेशन (HOIVG) के लिए एक एंड-टू-एंड मल्टीमॉडल AI फ्रेमवर्क है, जो टेक्स्ट प्रॉम्प्ट्स, रेफरेंस इमेजेस, ऑडियो और पोज सीक्वेंस को एकीकृत करके उच्च-फिडेलिटी वीडियो उत्पन्न करता है जिसमें यथार्थवादी मानव-उत्पाद इंटरैक्शन होते हैं।
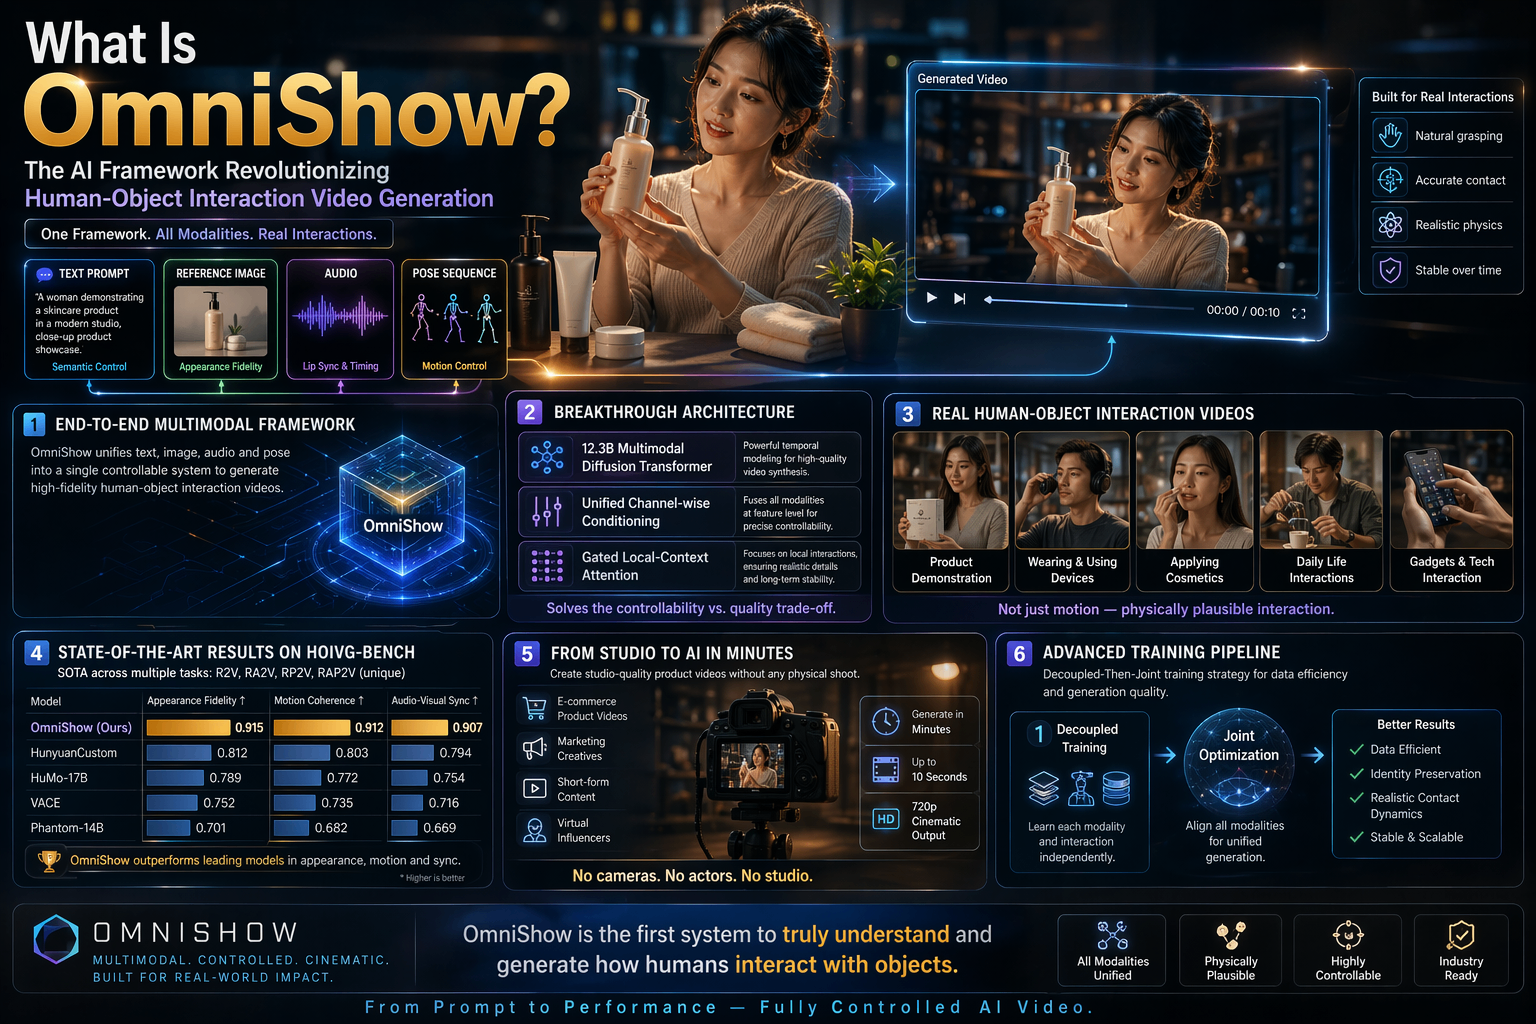
- 123 अरब पैरामीटर वाले मल्टीमॉडल डिफ्यूजन ट्रांसफॉर्मर पर आधारित, इसमें Unified Channel-wise Conditioning और Gated Local-Context Attention पेश किया गया है जो नियंत्रणीयता-गुणवत्ता के ट्रेड-ऑफ को हल करता है और सटीक सिंक्रोनाइजेशन सुनिश्चित करता है।
- नवनिर्मित HOIVG-Bench पर बेंचमार्क्स दिखाते हैं कि OmniShow R2V, RA2V, RP2V और अनोखे RAP2V टास्क्स में स्टेट-ऑफ-द-आर्ट परिणाम प्राप्त करता है, और HunyuanCustom, HuMo-17B, VACE तथा Phantom-14B जैसे मॉडलों से एपीयरेंस फिडेलिटी, मोशन कोहेरेंस और ऑडियो-विजुअल सिंक में बेहतर प्रदर्शन करता है।
- व्यावहारिक अनुप्रयोग ई-कॉमर्स में उत्कृष्ट हैं, जो बिना फिजिकल शूटिंग के कुछ मिनटों में स्टूडियो-क्वालिटी उत्पाद प्रदर्शन वीडियो बनाने में सक्षम हैं, साथ ही 10 सेकंड तक के लॉन्ग-शॉट और 720p आउटपुट का समर्थन करते हैं।
- Decoupled-Then-Joint रणनीति के माध्यम से उन्नत प्रशिक्षण डेटा की कमी को संबोधित करता है, जिससे उद्योग-स्तरीय भौतिक यथार्थवाद, पहचान संरक्षण और प्राकृतिक पकड़/संपर्क गतिशीलता प्राप्त होती है।
OmniShow क्या है?
OmniShow मानव-वस्तु इंटरैक्शन वीडियो जेनरेशन (HOIVG) के लिए विशेष रूप से डिज़ाइन किया गया अत्याधुनिक AI फ्रेमवर्क है। यह मनुष्यों द्वारा वस्तुओं के साथ इंटरैक्ट करते हुए यथार्थवादी वीडियो संश्लेषित करता है—जैसे उत्पाद प्रदर्शन, पकड़ना या उपयोग करना—और एक साथ कई इनपुट्स पर कंडीशनिंग करता है: टेक्स्ट सेमांटिक्स के लिए, रेफरेंस इमेजेस विजुअल फिडेलिटी के लिए, ऑडियो सिंक्रोनाइजेशन के लिए, और पोज मोशन कंट्रोल के लिए।
ByteDance से संबद्ध शोधकर्ताओं द्वारा अप्रैल 2026 में जारी किया गया, OmniShow मौजूदा वीडियो जेनरेशन टूल्स में एक महत्वपूर्ण खाई को भरता है। पारंपरिक मॉडल अक्सर केवल एक या दो मोडैलिटी को हैंडल करते हैं और समय के साथ स्थिर, भौतिक रूप से यथार्थवादी इंटरैक्शन बनाए रखने में संघर्ष करते हैं। OmniShow सभी चार मोडैलिटी को एक ही एंड-टू-एंड सिस्टम में एकीकृत करता है, जो ई-कॉमर्स, शॉर्ट-फॉर्म कंटेंट और इंटरैक्टिव एंटरटेनमेंट के लिए सिनेमैटिक परिणाम उत्पन्न करता है।
फ्रेमवर्क का विश्लेषण दिखाता है कि यह वास्तविक दुनिया के उपयोगिता को प्राथमिकता देता है: आउटपुट में चरित्र और वस्तु की उपस्थिति सुसंगत रहती है, गति की गतिशीलता प्राकृतिक होती है, और जटिल परिदृश्यों में भी मजबूत संपर्क भौतिकी बनी रहती है।
OmniShow की मुख्य विशेषताएं
OmniShow चार प्राथमिक जेनरेशन मोड्स के माध्यम से मल्टीमॉडल नियंत्रण प्रदान करता है:
- Reference-to-Video (R2V): टेक्स्ट और रेफरेंस इमेजेस से उच्च-फिडेलिटी HOI वीडियो उत्पन्न करता है, उत्पाद उपस्थिति संरक्षण में उत्कृष्ट।
- Reference + Audio-to-Video (RA2V): लिप मूवमेंट्स, जेस्चर्स और expressive बोलने/गाने वाले अवतारों के लिए ऑडियो सिंक्रोनाइजेशन जोड़ता है।
- Reference + Pose-to-Video (RP2V): सटीक गति ट्रैजेक्टरी के लिए पोज सीक्वेंस शामिल करता है साथ ही प्रामाणिक वस्तु इंटरैक्शन सुनिश्चित करता है।
- Full Multimodal (RAP2V): सभी इनपुट्स को संयोजित करके सबसे अधिक नियंत्रणीय आउटपुट प्रदान करता है—उद्योग में पहला संयुक्त कंडीशनिंग।
अतिरिक्त क्षमताएं शामिल हैं:
- लॉन्ग-शॉट सपोर्ट 10 सेकंड तक, 24fps और 720p रिज़ॉल्यूशन पर।
- भौतिक यथार्थवाद: स्थिर पकड़, न्यूनतम पेनेट्रेशन, और सुसंगत छाया/लाइटिंग।
- पहचान संरक्षण: फ्रेम्स में मानव और वस्तु की सुसंगत उपस्थिति।
- क्लाउड-ऑप्टिमाइज्ड वर्कफ्लो Shopify, Amazon और TikTok Shop जैसे ई-कॉमर्स प्लेटफॉर्म्स के लिए।
ये विशेषताएं OmniShow को स्केलेबल कंटेंट क्रिएशन के लिए विशेष रूप से मूल्यवान बनाती हैं जहां सटीकता मायने रखती है।
OmniShow कैसे काम करता है: तकनीकी आर्किटेक्चर
OmniShow 123 अरब पैरामीटर वाले Waver 1.0 मल्टीमॉडल डिफ्यूजन ट्रांसफॉर्मर (MMDiT) पर आधारित है, जो latent diffusion और flow matching का उपयोग करता है। वीडियो को VAE के माध्यम से latent tokens में संपीड़ित किया जाता है, फिर मल्टीमॉडल इनपुट्स पर कंडीशनिंग करते हुए iteratively denoised किया जाता है।
मुख्य नवाचार
- Unified Channel-wise Conditioning: रेफरेंस इमेजेस और पोज सीक्वेंस को VAE-एन्कोड किया जाता है और noisy वीडियो tokens तथा pseudo-frame tokens के साथ concatenation के माध्यम से फीचर चैनल्स में सीधे इंजेक्ट किया जाता है। Binary masks सक्रियण को नियंत्रित करते हैं, साथ ही reference reconstruction loss के साथ। यह एडाप्टर-आधारित तरीकों में आम degradation के बिना उच्च विजुअल क्वालिटी बनाए रखता है।
- Gated Local-Context Attention: ऑडियो फीचर्स (Wav2Vec 2.0 द्वारा निकाले गए) को स्लाइडिंग-विंडो संदर्भ (साइज 5) के साथ पैक किया जाता है और dual-stream ब्लॉक्स में masked attention के माध्यम से इंजेक्ट किया जाता है। एक learnable gating vector प्रशिक्षण को स्थिर करता है और प्रभाव को मॉडुलेट करता है, केवल 2.5% मॉडल साइज बढ़ाकर सटीक एक्शन-साउंड अलाइनमेंट सुनिश्चित करता है।
- Decoupled-Then-Joint Training: पूर्ण मल्टीमॉडल पेयर्स के लिए डेटा की कमी को संभालने के लिए, अलग R2V और A2V मॉडल्स को heterogeneous डेटासेट्स पर प्रशिक्षित किया जाता है, फिर (6:4 अनुपात, ऑडियो संवेदनशीलता को प्राथमिकता देते हुए) मर्ज किया जाता है। RA2V और उच्च-गुणवत्ता RAP2V डेटा पर संयुक्त फाइन-ट्यूनिंग बिना ओवरफिटिंग के उभरती क्षमताओं को अनलॉक करती है।
पाइपलाइन इनपुट्स को समानांतर में प्रोसेस करती है, उन्हें क्रॉस-मॉडली फ्यूज करती है, और diffusion के माध्यम से रिफाइन करती है—परिणामस्वरूप आउटपुट निर्देशक-नियंत्रित महसूस होते हैं बजाय जेनेरिक एनिमेटेड के।
प्रदर्शन बेंचमार्क और तुलनाएं
कस्टम HOIVG-Bench (135 विविध 5-सेकंड क्लिप्स जिसमें मानव/वस्तु रेफरेंस, पोज और ऑडियो शामिल हैं) पर बेंचमार्क्स OmniShow की श्रेष्ठता प्रदर्शित करते हैं:
- R2V: रेफरेंस कंसिस्टेंसी (FaceSim 0.759, NexusScore 0.876) और समग्र गुणवत्ता में आगे है साथ ही मजबूत टेक्स्ट अलाइनमेंट बनाए रखता है।
- RA2V & RP2V: HunyuanCustom, HuMo-17B, AnchorCrafter और VACE से sync metrics (Sync-C/Sync-D), पोज एक्यूरेसी (AKD/PCK) और वीडियो क्वालिटी (AES/IQA) में बेहतर प्रदर्शन करता है।
- RAP2V: अनोखा पूर्ण समर्थन; लगभग सभी मेट्रिक्स में कैस्केडेड बेसलाइन्स को हराता है, जिसमें मोशन कोहेरेंस और भौतिक यथार्थवाद शामिल है।
समुदाय और शोध फीडबैक जटिल इंटरैक्शंस में कम आर्टिफैक्ट्स को हाइलाइट करते हैं। लॉन्ग-शॉट निरंतरता और फिजिक्स कंप्लायंस इसके मुख्य अंतर हैं।
वास्तविक दुनिया के अनुप्रयोग और ई-कॉमर्स प्रभाव
OmniShow व्यावहारिक परिदृश्यों में चमकता है:
- ई-कॉमर्स उत्पाद डेमो: उत्पाद फोटोज और वॉइसओवर से प्रोफेशनल अनबॉक्सिंग, उपयोग या ट्राई-ऑन वीडियो बनाएं—प्रोडक्शन लागत को हजारों से घटाकर प्रति वीडियो $10 से भी कम कर दें।
- मार्केटिंग कंटेंट: AI प्रेजेंटर के साथ UGC-स्टाइल शॉर्ट्स जनरेट करें जो फीचर्स को स्वाभाविक रूप से प्रदर्शित करें।
- क्रिएटिव वर्कफ्लो: मौजूदा वीडियो को रीमिक्स करें, ऑब्जेक्ट्स स्वैप करें, या ऑडियो-ड्रिवन एक्सप्रेशंस के साथ अवतार एनिमेट करें।
ब्रांड्स को तेज इटरेशन, उच्च कन्वर्जन रेट्स (उदाहरण: सोशल पर 67% CTR उछाल) और स्टूडियो या मॉडल्स के बिना सुसंगत ब्रांडिंग से लाभ होता है।
इष्टतम परिणामों के लिए उन्नत टिप्स
गुणवत्ता अधिकतम करने के लिए:
- सर्वोत्तम पहचान संरक्षण के लिए उच्च-रिज़ॉल्यूशन, फ्रंट-फेसिंग रेफरेंस इमेजेस का उपयोग करें जिसमें न्यूट्रल लाइटिंग हो।
- एक्शंस और कैमरा एंगल्स का वर्णन करने वाले स्पष्ट, संक्षिप्त टेक्स्ट प्रॉम्प्ट्स दें; जटिल हाथ-वस्तु इंटरैक्शन के लिए सटीक पोज सीक्वेंस के साथ पेयर करें।
- ऑडियो के लिए मैचिंग fps पर क्लीन वॉइसओवर का उपयोग करें; सिंक्रोनाइजेशन को रिफाइन करने के लिए पहले छोटे क्लिप्स टेस्ट करें।
- मल्टी-ऑब्जेक्ट हैंडलिंग या कैमरा मूवमेंट जैसे एज केस के लिए RAP2V मोड का लाभ उठाएं—R2V से शुरू करें फिर शर्तों को क्रमिक रूप से लेयर करें।
सामान्य समस्याएं और उन्हें कैसे बचाएं
- ** conflicting इनपुट्स**: अत्यधिक जटिल पोज के साथ मिसमैच्ड ऑडियो तीव्र गति में हल्का ब्लर या आर्टिफैक्ट्स पैदा कर सकता है; शुरू में एक मोडैलिटी को सरल बनाकर हल करें।
- डेटा की कमी के प्रभाव: प्रशिक्षण इसे कम करता है, लेकिन कम-गुणवत्ता रेफरेंस फिडेलिटी कम करते हैं—हमेशा HOIVG-Bench-स्टाइल स्टैंडर्ड्स के खिलाफ इनपुट्स वैलिडेट करें।
- शॉर्ट-क्लिप बायस: 5 सेकंड से आगे रियल आउटपुट्स भिन्न हो सकते हैं; टेम्पोरल कंसिस्टेंसी के लिए पूर्ण सीक्वेंस जनरेट और रिव्यू करें।
- डिफॉल्ट्स पर अत्यधिक निर्भरता: एडवांस्ड सेटअप में कस्टम गेटिंग और मास्क ट्यूनिंग जीरो-शॉट उपयोग से बेहतर परिणाम देती है।
इन्हें संबोधित करने से विश्वसनीय, प्रोडक्शन-रेडी वीडियो सुनिश्चित होते हैं।
निष्कर्ष
OmniShow नियंत्रणीय वीडियो जेनरेशन में एक महत्वपूर्ण छलांग है, जो पेशेवर मानव-वस्तु इंटरैक्शन कंटेंट को बड़े पैमाने पर सुलभ बनाता है। इसका एकीकृत मल्टीमॉडल दृष्टिकोण, कठोर नवाचारों और बेंचमार्क्स द्वारा समर्थित, AI वीडियो टूल्स में यथार्थवाद और व्यावहारिकता के लिए नया मानक स्थापित करता है।
ई-कॉमर्स टीमों, क्रिएटर्स या शोधकर्ताओं के लिए जो वीडियो प्रोडक्शन को बदलने के लिए तैयार हैं, आधिकारिक प्रोजेक्ट पेज या कमर्शियल इम्प्लीमेंटेशंस का अन्वेषण करें और आज ही सिनेमैटिक HOI वीडियो जनरेट करना शुरू करें। उत्पाद कहानी कहने का भविष्य आ गया है—एक सटीक, मल्टीमॉडल प्रॉम्प्ट के साथ।
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
PaidSync.ai
MCP ServersPaidSync.ai is a hosted MCP server for paid advertising that exposes 610+ tools across 14 advertising, analytics, tagging, and commerce platforms. It supports read/write workflows from AI clients including ChatGPT, Claude, Gemini, Cursor, Claude Code, and Codex, with a free plan.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.