Por Que a Tradução Fica Lenta Após Conectar ao OpenRouter? Principais Causas e Soluções Rápidas 2026
Principais Conclusões
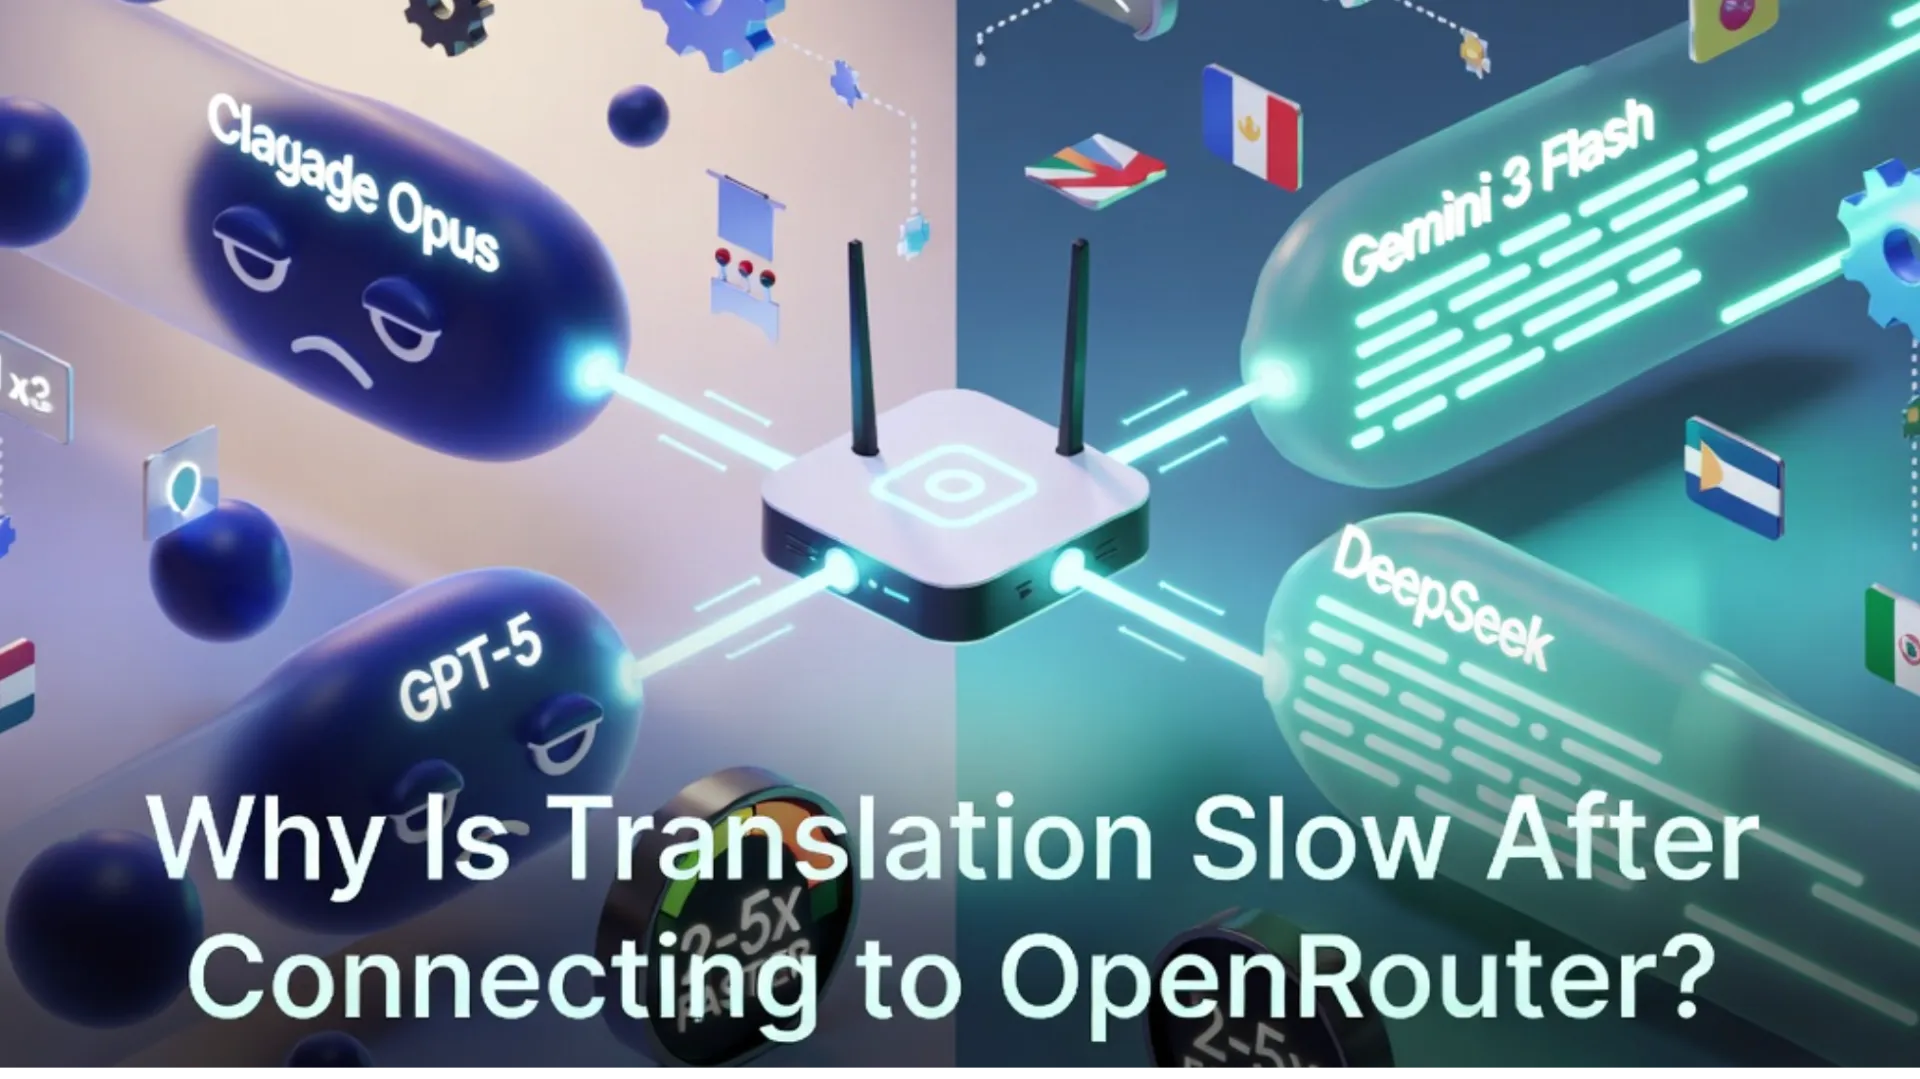
- A causa número 1 da tradução lenta no OpenRouter é usar modelos inerentemente lentos (Claude Opus/Sonnet, classe GPT-5, Gemini Pro) em vez dos rápidos.
- O roteamento padrão prioriza custo sobre velocidade — alterar para Latência (menor primeiro) frequentemente traz melhoria imediata.
- O mau processamento em lote (chamadas seriais, sem streaming, prompts longos não fragmentados, temperatura alta) é extremamente comum e fácil de corrigir.
- Saldo de créditos baixo e cache frio nas primeiras solicitações também contribuem significativamente.
- Mudar para modelos rápidos como Gemini 3 Flash, DeepSeek V3/V4, Qwen3 ou Mistral Small pode tornar a tradução 2-5x mais rápida, mantendo boa qualidade para a maioria dos casos de uso.
Principais Causas de Tradução Lenta no OpenRouter (Classificadas por Frequência)
1. Usar um Modelo Lento (Causa Mais Comum)
Muitos usuários conectam ao OpenRouter e continuam usando modelos de alta qualidade, mas lentos:
- Claude Opus / Sonnet 4.x: Melhor qualidade, mas inferência significativamente mais lenta, especialmente em textos longos. Quanto maior o contexto, mais óbvia a lentidão.
- Modelos Gemini Pro / classe GPT-5: Excelente qualidade, mas sofrem com filas longas durante horários de pico.
Correção: Mude para modelos mais rápidos otimizados para velocidade:
- Gemini 3 Flash (ou Flash Lite)
- DeepSeek V3 / V4
- Qwen3-235B
- Mistral Small
Esses modelos são tipicamente 2-5 vezes mais rápidos em tarefas de tradução e oferecem qualidade suficiente para uso diário, documentos, novelas visuais e a maioria do trabalho profissional.
2. Estratégia de Roteamento Padrão Não Priorizando Velocidade
Mesmo com o mesmo modelo, o OpenRouter tem vários provedores de backend. Por padrão, ele frequentemente escolhe o provedor disponível mais barato, que pode ser mais lento ou sob carga pesada.
Correções:
- No Painel do OpenRouter → Configurações → Roteamento, altere Ordenação Padrão do Provedor para Latência (menor primeiro).
- Na sua solicitação de API, adicione parâmetros de roteamento:
json { "model": "google/gemini-3-flash", "provider": { "sort": "latency" }, "stream": true }
Isso força o OpenRouter a escolher o backend disponível mais rápido para sua solicitação.
3. Processamento em Lote Subótimo (Muito Comum)
- Chamar traduções em série em vez de em paralelo (sem ThreadPool ou asyncio)
- Enviar prompts muito longos + documentos completos em uma única solicitação sem fragmentação
- Configurações de temperatura altas (tradução funciona melhor com temperature=0.2~0.3)
- Não usar streaming — o cliente aguarda a resposta completa antes de mostrar qualquer coisa
Correções:
- Use processamento paralelo com asyncio ou concurrent.futures
- Divida textos longos em fragmentos menores (500-1500 tokens cada)
- Defina temperature=0.2 ou 0.3 para tradução
- Sempre habilite stream=True para uma velocidade percebida muito melhor
4. Problemas de Conta, Crédito e Cache
- Saldo muito baixo (dólares de um dígito) ou próximo dos limites → O OpenRouter limpa agressivamente os caches e adiciona verificações extras, desacelerando cada solicitação.
- Horários de pico (especialmente no horário da tarde da Costa Oeste dos EUA) causam uma carga global maior nos provedores populares.
- Inicialização a frio nas primeiras solicitações após conectar ou após longa inatividade (os caches se aquecem após algumas chamadas).
Correções:
- Mantenha um saldo de pelo menos US$ 10–20 e ative a recarga automática
- Envie algumas solicitações de aquecimento ao iniciar uma nova sessão ou em uma nova região
- Evite executar lotes pesados durante os horários de pico conhecidos, se possível
Lista de Verificação para Otimização Rápida
- Mude para um modelo rápido (Gemini 3 Flash recomendado primeiro)
- Defina o roteamento padrão como Prioridade de Latência no painel
- Ative streaming + temperatura baixa
- Divida textos longos e use chamadas paralelas
- Mantenha um saldo de crédito saudável
A maioria dos usuários vê melhorias significativas de velocidade em minutos após aplicar as 2–3 primeiras correções.
Conclusão
A desaceleração da tradução após conectar-se ao OpenRouter raramente é causada pela plataforma em si. Na maioria dos casos, trata-se da escolha do modelo, das configurações de roteamento e dos hábitos de processamento em lote.
Ao mudar para modelos mais rápidos e configurar o roteamento com prioridade de latência, você pode obter traduções 2 a 5 vezes mais rápidas mantendo uma excelente qualidade. Comece com o Gemini 3 Flash e a mudança para roteamento de latência — a diferença geralmente é imediata.
Abra seu painel do OpenRouter agora, atualize suas configurações de roteamento padrão e teste um modelo rápido em sua próxima tarefa de tradução. Você provavelmente ficará surpreso com o quanto mais rápido pode ser.
Continue Reading
More articles connected to the same themes, protocols, and tools.
O Que É o OC Maker? A Ferramenta de IA que Está Revolucionando a Criação de Personagens Originais em 2026
Google Investe Até US$ 40 Bilhões na Anthropic com Suporte de 5GW de Computação: Corrida Armamentista de IA Entra em Nova Era
Acesso Não Autorizado à IA Mythos da Anthropic: Como um Grupo do Discord Violou o Modelo de Cibersegurança 'Muito Perigoso'
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.