为什么接入 OpenRouter 翻译速度有点慢?2026 深度排查 + 提速 5 倍实战指南
Key Takeaways
- OpenRouter 自身仅增加 15-40ms 延迟,主要瓶颈来自底层提供商队列、低余额激进缓存过期及中国到海外的网络跳数。
- 最常见原因:默认路由未优先 latency、选用 Claude 4.6 Opus 等慢模型,或批量串行调用。
- 2026 年最新数据:低余额账户(个位数美元)会触发缓存激进过期,导致时延翻倍;2 月曾因第三方缓存依赖出现短暂中断。
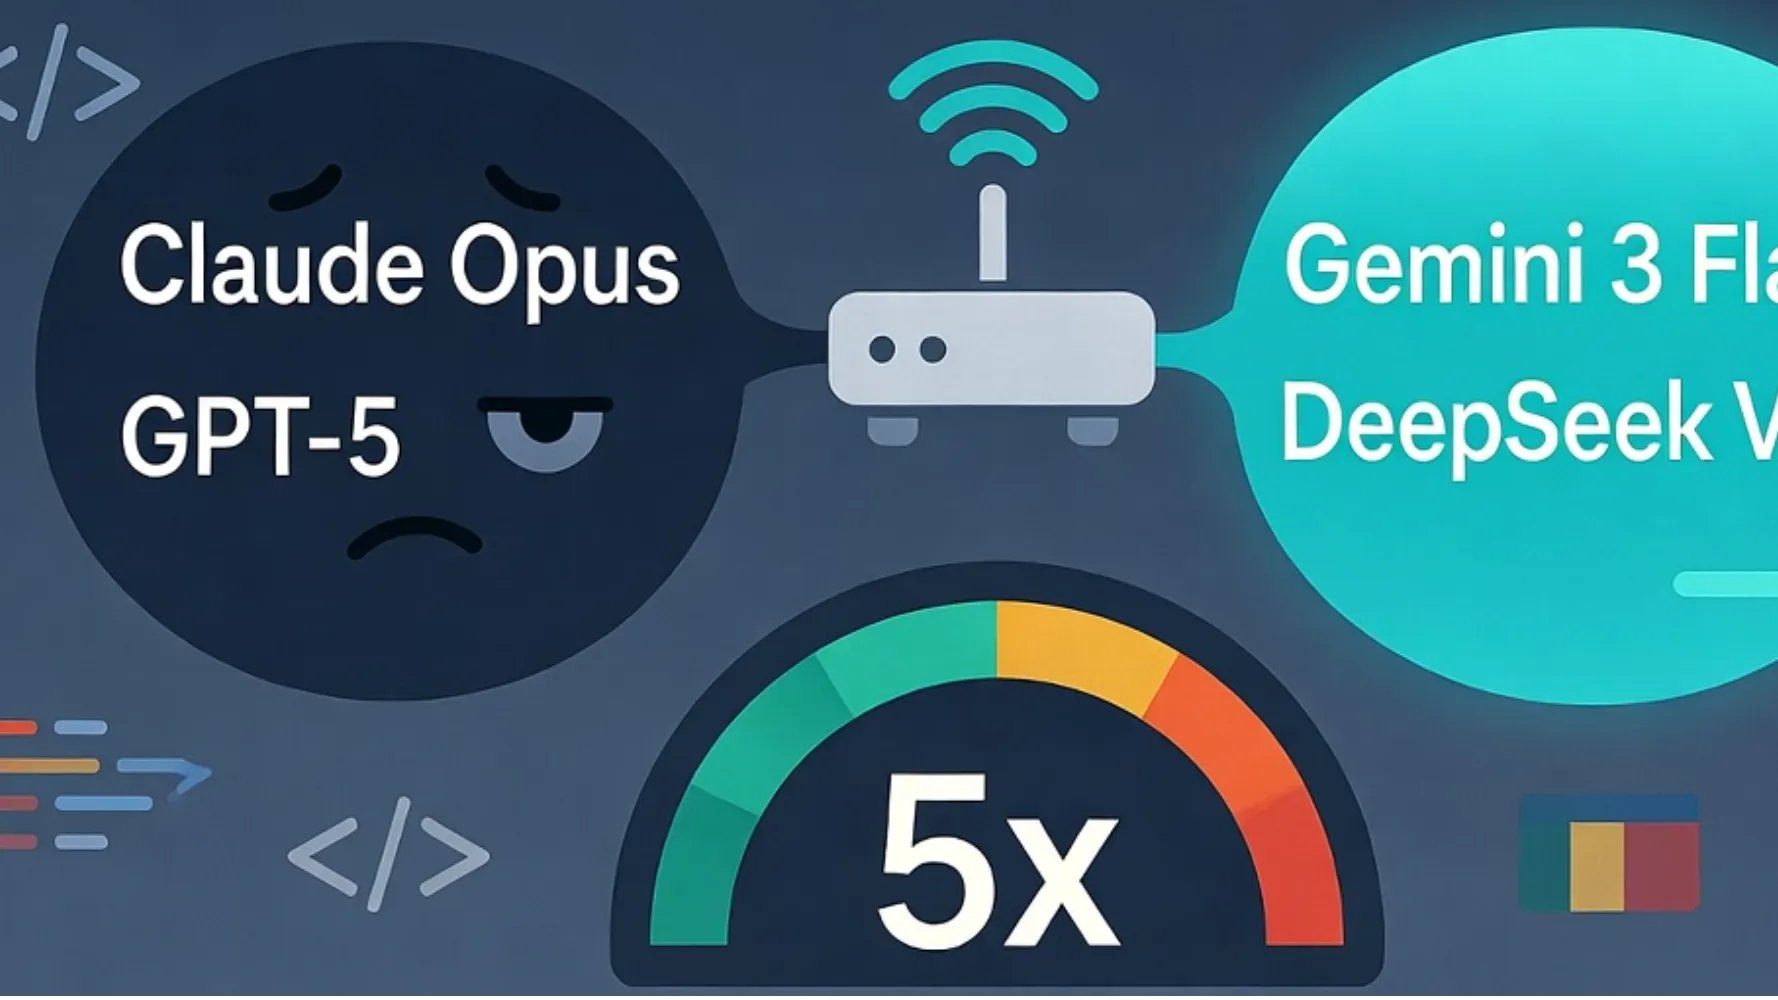
- 批量翻译提速方案:切换 Gemini 3 Flash / DeepSeek V3.2 + provider sort: "latency" + asyncio 并行,可提速 3-5 倍。
- 中国用户优先国产高吞吐模型(DeepSeek / MiniMax / Qwen3),或搭配 n1n.ai 低延迟聚合平台。
- 正确配置后,翻译速度可接近直连提供商,同时保留 500+ 模型灵活路由。
OpenRouter 翻译速度慢的核心原因分析
OpenRouter 作为全球最大 LLM 路由网关,本质是 Cloudflare Workers 驱动的反向代理 + 智能路由层。分析显示,其自身添加的延迟通常控制在 15-40ms(缓存热后),但实际翻译任务中速度慢往往是多环节叠加的结果。
1. 底层提供商推理速度与队列差异
翻译属于输出密集型任务,长 prompt + 大量输出 tokens 时,Claude 4.6 Opus/Sonnet、Gemini Pro 等高质量模型推理耗时明显高于 Gemini 3 Flash、DeepSeek V3.2(可达 40-100+ tokens/s)。基准显示,高峰期(美西时间晚上)提供商队列长度直接决定 TTFT(Time To First Token)和 TPOT(Time Per Output Token)。
2. 默认路由策略未优先速度
OpenRouter 默认按价格 + 可用性负载均衡,容易选中便宜但队列长的提供商。2026 年官方文档明确指出,未设置 provider.sort 时,高峰期延迟显著增加。
3. 低余额与缓存激进过期机制
OpenRouter 性能指南显示,当账户余额降至个位数美元或接近限额时,平台会激进过期缓存以确保计费准确,导致冷启动时延增加 2-3 倍。这是许多用户忽略的隐藏杀手。
4. 中国用户网络路径与地域延迟
请求路径:客户端 → OpenRouter(海外 PoP)→ 底层提供商。额外跳数常带来 100-300ms 基线延迟。2026 年亚洲流量激增(中国模型 token 占比已超美国),高峰期网络拥堵进一步放大问题。
5. 批量处理实现问题
- 串行而非并行调用(总耗时线性累加)。
- 单次超长上下文(128K+)未分段。
- 未开启
stream=True或温度过高。 - 每次新建 client,未复用连接。
6. 提供商故障回退与 2026 年已知事件
失败的首次 completion 会额外增加单次请求时延。2026 年 2 月 OpenRouter 曾因第三方缓存依赖出现短暂中断,影响部分用户感知速度。智能 fallback 虽提升可用性,但首次失败仍会累积延迟。
7. 其他边缘情况
- 首次冷启动缓存未热。
- 使用 thinking/reasoning 模式或超大上下文。
- 高峰期提供商 429 限流。
模型速度与成本对比(翻译场景 2026 数据)
| 模型 | 输入价格 ($/M tokens) | 输出价格 ($/M tokens) | 典型翻译速度 (tokens/s) | 推荐场景 | 优势 |
|---|---|---|---|---|---|
| DeepSeek V3.2 | 0.26-0.28 | 0.38-0.42 | 37-60 | 日常/大批量 | 性价比最高,输出最便宜 |
| MiniMax M2.7 | 0.30 | 1.20 | 40-100+ (Lightning 模式) | 长上下文/高质量 | 单次响应更快,上下文 205K |
| Gemini 3 Flash | 极低 | 极低 | 80+ | 日常/移动端 | 速度与免费额度最佳 |
| Claude 4.6 Sonnet | 中等 | 中等 | 25-40 | 最高质量 | 语感最佳,但速度较慢 |
独特洞察:翻译任务输出 tokens 远多于输入,DeepSeek V3.2 输出价格仅为 MiniMax M2.7 的 1/3,大批量时可节省 50%以上费用。
如何快速诊断与优化(立即见效)
路由设置优化(最简单有效)
登录 OpenRouter dashboard → Settings → 将 Default Provider Sort 改为 Latency (lowest first)。API 请求中添加:
"provider": {
  "sort": "latency"
}
这会禁用价格负载均衡,强制优先最低延迟提供商。
代码层优化(批量翻译必备)
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="your_key"
)

async def translate_segment(text):
    response = await client.chat.completions.create(
        model="deepseek/deepseek-v3.2",  # 或 google/gemini-3-flash
        messages=[{"role": "user", "content": prompt}],
        temperature=0.3,
        stream=True,
        extra_body={"provider": {"sort": "latency"}}
    )
    # 处理流式输出...

async def batch_translate(texts):
    tasks = [translate_segment(t) for t in texts]
    return await asyncio.gather(*tasks)
分段建议:每段 800-1500 tokens,翻译后合并保持术语一致。
中国用户专属优化
- 优先 DeepSeek V3.2 / MiniMax M2.7 / Qwen3 等国产模型(2026 年 OpenRouter token 量已领先)。
- 搭配 n1n.ai 等国内优化平台(1:1 汇率 + 加速节点)。
- 保持账户较高余额,避免缓存激进过期。
常见误区与避坑指南
- 误区一:认为 OpenRouter 本身很慢 —— 99% 是提供商或配置问题。
- 误区二:只追求单一最高质量模型 —— 批量场景下快模型 + 少量润色效率更高。
- 误区三:忽略并行与分段 —— 导致总耗时线性爆炸。
- 边缘情况:高峰期手动切换快模型;低余额时及时充值;长文档预总结上下文减少 tokens。
Conclusion
接入 OpenRouter 翻译速度慢是路由灵活性与底层性能权衡的结果,而非不可解决的问题。2026 年通过 latency 优先路由、快模型选择、异步并行代码,中国用户完全可实现接近原生提供商的速度,同时享受多模型智能切换的便利。
立即行动:登录 OpenRouter dashboard 调整 provider sort 为 latency,切换 DeepSeek V3.2 或 Gemini 3 Flash 测试一批翻译任务,速度提升通常立竿见影。
如果你正处理小说、合同、视频字幕或海量电商描述,欢迎在评论区分享具体模型、批量规模和语言方向,一起讨论更针对性的 2026 年优化方案。
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.