TurboQuantとは?GoogleのブレークスルーAI圧縮でKVキャッシュを6倍小さく、推論を8倍高速化
主な要点
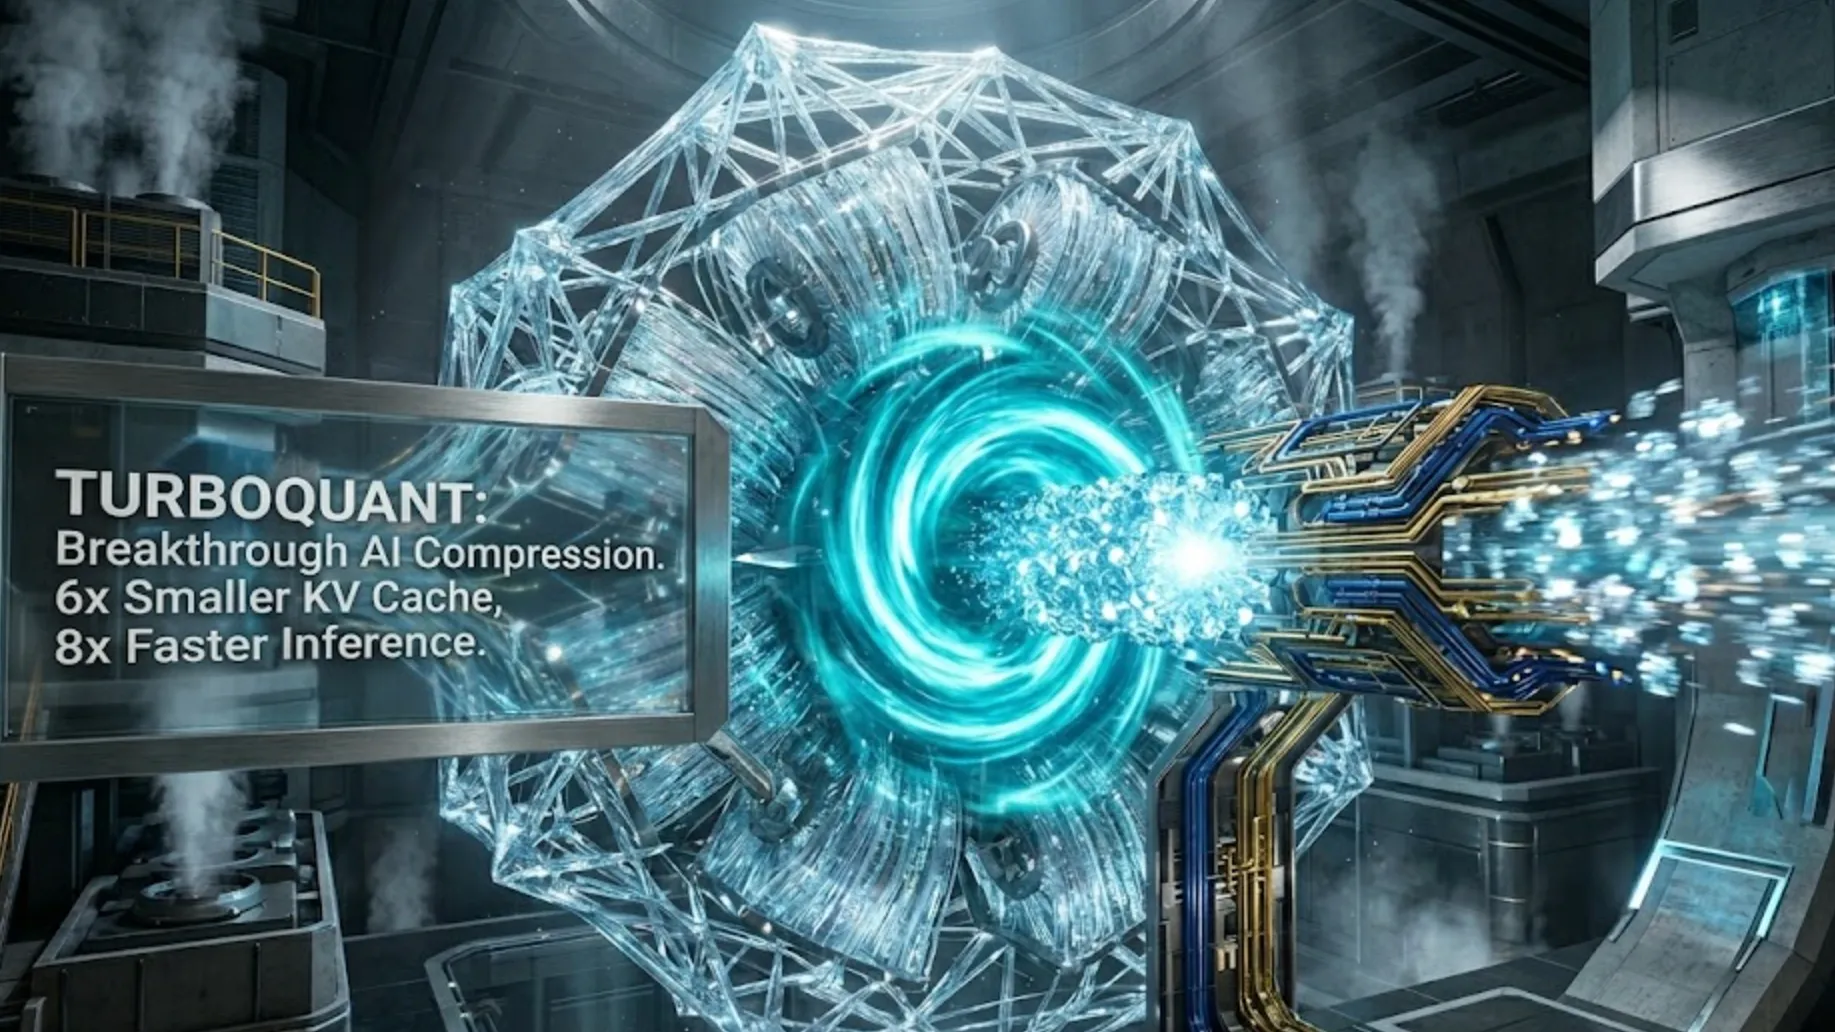
- TurboQuantは、Google Researchが開発したオンライン・ベクトル量子化アルゴリズムであり、大規模言語モデル(LLM)のキー・バリュー(KV)キャッシュを、LongBench、Needle-in-a-Haystack、RULERなどのベンチマークにおいて精度損失ゼロを達成しながら、値あたりわずか3ビットへと圧縮します。
- ベンチマークによると、32ビット・ベースラインと比較して、KVキャッシュにおいて6倍のメモリ削減を実現し、NVIDIA H100 GPU上のアテンション・ロジット計算において最大8倍の高速化を示しています。
- これは、トレーニングやファインチューニングを必要とせず、Gemma、Mistral、Llama、Qwenなどの既存モデルに即座に適用可能です。
- コミュニティからのフィードバックでは、この技術により、消費者向けハードウェアで大幅に長いコンテキスト・ウィンドウを扱えるようになり、フル・プレシジョン推論とほぼ同等の出力品質を実現できると示唆されています。
- この手法は、ランダムな直交回転、主圧縮のためのPolarQuant、そして残差補正のための1ビット量子化Johnson-Lindenstrauss(QJL)を組み合わせています。
TurboQuantとは何か?
TurboQuantは、Google Researchが開発した高度なベクトル量子化手法であり、大規模言語モデルおよび高次元ベクトル検索の効率性を再定義します。2026年3月下旬に発表され、ICLR 2026で発表予定のこの技術は、トランスフォーマー推論における重大なメモリボトルネックであるKVキャッシュをターゲットとしています。
分析によると、コンテキスト長が数万または数十万トークンにまで成長するにつれ、すべてのトークンに対して事前計算されたキーおよびバリュー・ベクトルを格納するKVキャッシュは、GPUメモリを数ギガバイト消費し、推論コストを支配する可能性があります。TurboQuantは、これらの高次元ベクトル(通常は16ビットまたは32ビット浮動小数点数)を、モデルの品質や速度における従来のトレードオフなしに、超低プレシジョンに圧縮します。
キャリブレーション・データを必要とし、それでも精度低下が発生する従来のポストトレーニング量子化とは異なり、TurboQuantはデータ非依存であり、平均二乗誤差(MSE)と内積歪みの両方に対して、情報理論的限界に近づくことが数学的に証明されています。
現代LLMにおけるKVキャッシュのボトルネック
トランスフォーマー・アーキテクチャでは、セルフ・アテンションは、過去に見たトークンのキーとバリューを再計算することを避けるためにKVキャッシュに依存しています。隠れ次元 d とシーケンス長 n を持つモデルでは、キャッシュは O(n × d × レイヤー数 × ヘッド数 × 値あたりのバイト数) として線形に増加します。
ベンチマークは、このキャッシュが長コンテキストタスク中にモデル重みをサイズで超える可能性があることを示しています。標準的な16ビットKVストレージは、消費者向けGPUやvLLMのような高スループット・サービング環境において、すぐに許容できないものになります。従来の圧縮の試み(例えば、ブロックごとのスケールを伴う4ビットまたは8ビット量子化)は、正規化定数を格納することによるメモリオーバーヘッドを導入し、現実世界での利得をせいぜい2-3倍に制限し、出力のズレを引き起こすリスクがありました。
TurboQuantはこのオーバーヘッドを完全に排除し、以前は8kでさえ苦労していたハードウェア上で、32k–128k+のコンテキスト・ウィンドウを持つモデルの実用的なデプロイメントを可能にします。
TurboQuantの仕組み: 技術的詳細解説
TurboQuantは、正確なアテンションスコアに不可欠なMSE(平均二乗誤差)と内積保存の両方を最適化した、二段階のオンラインアルゴリズムとして動作します。
段階1: ランダム回転 + PolarQuant圧縮
-
ランダム直交回転: 各入力KVベクトルは、データに依存しないランダムな直交変換(ガウシアン行列のQR分解による)を受けます。これにより係数値が次元全体に均等に再分配され、LLM活性化に典型的な準疎構造が、扱いやすい分布へと変換されます。
回転後、各座標は[-1, 1]上の既知の**Beta((d-1)/2, (d-1)/2)**分布に従います。この予測可能性により、最適な量子化セントロイドを解析的に事前計算することが可能となります。
-
PolarQuant(高品質スカラー量子化):
- ベクトルは正規化され、次元を再帰的にペアリングすることでデカルト座標から極座標へ変換されます。
- 半径が大きさを捕捉し、角度が方向性(意味的)情報をエンコードします。
- 角度分布が集中しており予測可能であるため、ブロックごとの高コストな正規化定数が不要になります。
- Beta分布に対するMSEを最適化したロイド・マックス量子化器が、各座標を低ビットの離散値(例: メイン段階で合計3ビット)にマッピングします。
この段階が圧縮の大部分(ビットの大半)を担い、ほぼ全てのベクトル情報を保存します。
段階2: QJL残留誤差補正
PolarQuantの後にわずかな残留誤差が残ります。TurboQuantは、ベクトルごとにわずか1ビット(+1または5の符号)を使用する量子化ジョンソン・リンデンストラウス(QJL)変換を適用します。これによりメモリオーバーヘッドを追加することなく、内積のバイアスを補正します。
結果として、再構成されたベクトルはオリジナルとのほぼ完全なコサイン類似度と内積相関(コミュニティテストでは3ビットで0.983以上)を達成します。
このプロセス全体はアクセラレータに適しており、融合されたTritonカーネルにより、圧縮されたインデックスからアテンション・ロジットを直接計算することが可能です——推論中に完全な逆量子化は必要ありません。
ベンチマークと実世界での性能
独立したベンチマークとGoogleの内部評価により、優れた結果が確認されています:
- メモリ:3ビットKVキャッシュは16ビットベースラインと比較して 約6倍の削減 をもたらし、4ビットバリアントでは一部のワークロードで8倍の実効的な向上を達成します。
- 速度:4ビットTurboQuantはH100 GPU上で、非量子化32ビットキーと比較して 最大8倍高速な アテンション計算を実現します。
- 精度:8k~64kコンテキストにわたるNeedle-in-a-Haystackで完全なリコールを達成。Gemma、Mistral、Qwen3.5などのモデルにおいて、LongBench、ZeroSCROLLS、RULER、L-Evalでの劣化はゼロです。
- コミュニティテスト(例:RTX 4090上のGemma-3-4B):
- 2ビット融合カーネル:fp16ベースラインと同一の出力、KVキャッシュは26MBから7MBに削減。
- エンドツーエンドのスループットはベースラインと同等または上回りながら、70%以上のVRAM使用量削減を実現。
GloVe(d=200)でのベクター検索評価では、Product Quantization(PQ)やRabbiQと比較して、より小さなコードブックとデータセットチューニングなしにもかかわらず、優れたtop-kリコールを実現しています。
TurboQuantの実装方法:ステップバイステップガイド
Googleは公式の実運用コードをリリースしていませんが、オープンソースコミュニティが発表から数日で実用的な実装を提供しました。今日から始める方法は以下の通りです。
1. PyTorchでのクイックスタート(研究/プロトタイピング)
tonbistudio/turboquant-pytorchのスクラッチ実装を使用します:
- リポジトリをクローンし、依存関係(PyTorch + Triton)をインストール。
- モデルの隠れ次元と目標ビット幅に対応するLloyd-Maxコードブックを事前計算。
- Hugging Face
DynamicCacheをパッチし、すべてのcache.update()呼び出しで量子化を実行。 - デモスクリプトを実行:
python run_demo.py --fused --bits 3(Gemma-3-4Bなど)。
融合Tritonカーネルはクエリを一度だけ事前回転し、uint8インデックスから直接ドット積を計算することで、1.2倍以上のエンドツーエンド高速化を実現します。
2. vLLMでの実運用サーバー
フォークされたvLLM統合(例:mitkox/vllm-turboquantまたはflash7777/vllm turboquantブランチ)を使用します:
- カスタムvLLMビルドをインストール。
- エンジン引数でTurboQuantを有効化(2~4ビットキー/値に対応)。
- 既存のOpenAI互換サーバーでデプロイ – モデル変更は不要です。
- 長文脈ワークロードでは、KVキャッシュ削減と高いスループット向上を即座に期待できます。
3. Apple Siliconでのローカル推論(MLX)
MLXネイティブポート(例:helgklaizar/turboquant_mlx)により、MシリーズMacでTurboQuantを利用可能:
pip install mlx-turboquant(コミュニティパッケージが利用可能)。- MLX経由でモデルをロードし、キャッシュラッパーを適用。
- 32k+コンテキストでのオンデバイス実験に最適です。
4. llama.cpp 統合(CPU/GPU)
GGUF互換モデル向けに、実験的なブランチ(TheTom/llama-cpp-turboquant)が積極的に最適化されています。
プロ向けのヒント:
- 感知可能な品質劣化をゼロにするには、3ビットまたは4ビットから始めてください。
- オーバーヘッドを最小限に抑えるために、融合カーネル内で事前に回転されたクエリパスを使用します。
- 忠実度を検証するために、まずNeedle-in-a-Haystackでテストします。
nvidia-smiなどのツールでVRAMを監視します — 4~7倍の実効的なコンテキスト拡大を見込んでください。
vLLM、TensorRT-LLM、およびllama.cppでの主流サポートは、最適化が成熟するにつれて数週間以内に期待されます。
TurboQuant vs. 従来の量子化手法
従来のアプローチ(例:GPTQ、AWQ、基本的なint4)はグループごとのスケールとキャリブレーションに依存しており、しばしば値ごとに1~2ビットのオーバーヘッドを導入し、長いコンテキストの性能を低下させます。製品量子化には、大規模でデータセット固有のコードブックとオフライン調整が必要です。
TurboQuantは際立っています:
- ゼロオーバーヘッド: 格納された定数やブロックごとのメタデータはありません。
- データ非依存: どのモデルでもすぐに動作します。
- ほぼ最適な歪み: MSEと内積の両方に対して数学的に証明されています。
- オンライン対応: 推論中に無視できる遅延で実行されます。
コミュニティ実装は、標準的な4ビット手法が失敗する場所でも、積極的な2ビットTurboQuantが完全精度の出力品質に匹敵することを示しています。
アプリケーションと将来の影響
TurboQuantが解き放つもの:
- より長いコンテキストをコンシューマーハードウェアで実現(例:単一のRTX 4090で128kトークン)。
- コスト削減: クラウドプロバイダー向けに推論費用を最大50%以上削減。
- エッジAI: 効率的な意味検索とオンデバイスLLM。
- ベクトルデータベース: 最先端の再現率で、より高速で密なインデックス。
採用が広がるにつれて、70B+モデルをモバイルやノートパソコン領域に押し込む、重み+KVキャッシュ量子化パイプラインのハイブリッド化が期待されます。
結論
TurboQuantは、AIシステムエンジニアリングにおける希少な躍進を表しています:品質を損なうことなく極端な効率向上を実現します。ランダム回転、極座標幾何学、残差補正という洗練された数学的洞察を通じてKVキャッシュのボトルネックを解決することで、Google Researchはコミュニティがすでに本番対応ツールに変えつつある青写真を提供しました。
ローカルモデルの実行、高スループットAPIの提供、ベクトル検索アプリケーションの構築のいずれにおいても、今が実験の時です。コミュニティ実装をクローンし、現在のセットアップとベンチマークを比較し、コンテキストウィンドウを劇的に拡大してください。メモリ制約のあるAIの時代は終わりを告げています — TurboQuantにより、より大きく、より速く、より安価な推論が今日、現実のものとなります。
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.