LongCat-Nextとは?美团のブレークスルー型ネイティブマルチモーダルAIモデル解説
主要ポイント
- LongCat-Next は、美団のLongCatチームによって開発されたオープンソースのネイティブマルチモーダル基盤モデルで、2026年3月にリリースされました。
- このモデルは、Discrete Native Autoregression (DiNA) パラダイムと次トークン予測(NTP)を使用して、テキスト、視覚(画像)、および音声 を単一の離散トークン空間に統合しています。
- LongCat-Flash-Lite MoE バックボーン(A3B: 総パラメータ約68.5B、活性化3B)上に構築されており、最小限の帰納的バイアスでモダリティを横断する理解と生成をサポートします。
- 主要な革新には、dNaViT(任意解像度の離散ネイティブVision Transformerトークナイザー)が含まれ、特にテキストレンダリングにおいて品質を保ちながら高い圧縮率(最大28倍)を実現しています。
- ベンチマークでは、視覚理解、画像生成、音声理解、および低遅延音声インタラクションにおいて、専門モデルと競合する性能を示しています。
- Hugging FaceとGitHubでMITライセンスの下に完全オープンソース化されており、推論コードとライブデモが利用可能です。
LongCat-Nextとは?
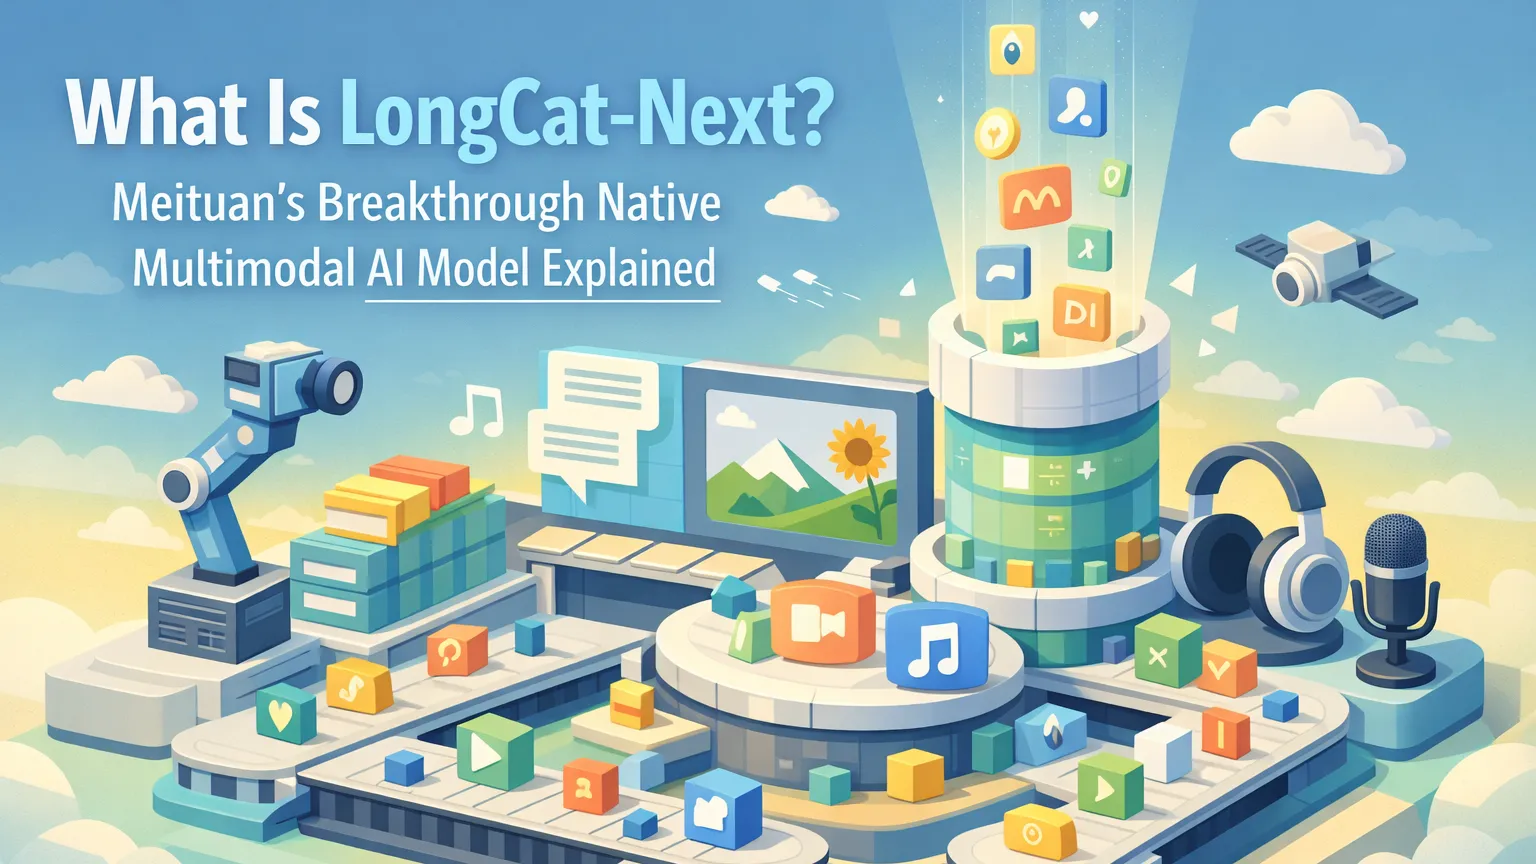
LongCat-Nextは、マルチモーダルAIアーキテクチャにおける重要な転換点を表しています。言語モデルコアに視覚エンコーダーや音声モジュールを接ぎ木した従来の「寄せ集め」システムとは異なり、このモデルはすべてのモダリティを単一の統一フレームワーク内のネイティブ要素として扱います。
美団のLongCatチームによって開発されたLongCat-Nextは、モダリティを離散トークンとして語彙化します。画像、音声波形、テキストは共有語彙にトークン化され、同じ自己回帰目標(次トークンの予測)を使用してモデルが処理および生成できるようになります。
この「Discrete Native Autoregression」(DiNA)アプローチは、言語モデリングパラダイムを超えたアーキテクチャの複雑さと帰納的バイアスを最小限に抑えます。その結果、真のany-to-any(任意対任意)マルチモーダル能力を持つ、よりエレガントでスケーラブルなシステムが実現します。
コアアーキテクチャと技術革新
Discrete Native Autoregression (DiNA)
LongCat-Nextの中核では、次トークン予測パラダイムがすべてのモダリティに拡張されています。ペアになったトークナイザーが入力を離散IDに変換します:
- テキスト:標準的なサブワードトークン化。
- 視覚:dNaViT を介して処理されます — これは、固定パッチングやリサイズアーティファクトなしで可変画像サイズを扱う、任意解像度の離散ネイティブVision Transformerです。
- 音声:理解、生成、低遅延会話をサポートする離散トークンに変換されます。
すべてのトークンは、共有のMoE(Mixture of Experts)バックボーンに供給されます。これにより、関連する音声を生成しながら画像を説明する、またはその逆など、シームレスなクロスモーダル推論が可能になります。
モデルの規模と効率性
- バックボーン: LongCat-Flash-Lite MoE アーキテクチャを採用しており、総パラメータ数は約 685 億、推論ステップごとのアクティブパラメータ数は約 30 億です。
- 効率性: 離散トークンアプローチと MoE 設計により、同等の能力を持つ高密度モデルと比較して軽量な推論を実現しています。
- 圧縮率: 高い圧縮率(例:画像で28倍)でも優れた生成品質を達成し、特に生成された視覚コンテンツ内での正確なテキストレンダリングに優れています。
このアーキテクチャは、マルチモーダル理解(例:視覚的質問応答、文脈を考慮した音声書き起こし)と生成(例:テキストから画像への変換、トークンを介した画像編集、音声合成)の両方をサポートしています。
性能とベンチマーク
公開されている技術レポートやコミュニティ評価の分析によると、LongCat-Next は複数の領域で産業レベルの結果を提供しています:
- 視覚理解: 複雑なシーン、文書、任意解像度の入力を含むベンチマークにおいて、専門的な視覚言語モデルと競合する性能を発揮します。密集した数式、OCR処理が難しい画像、実世界の写真を効果的に処理します。
- 画像生成: 高い忠実度と一貫性を維持し、多くのマルチモーダルシステムで弱点とされる、画像内の読み取り可能なテキストのレンダリングに特に強みを示します。
- 音声/音声処理: 高度な音声理解、低遅延の音声会話、カスタマイズ可能な音声クローニングに優れています。視覚コンテンツを参照しながら話すなど、自然なマルチモーダル相互作用をサポートします。
- クロスモーダルタスク: 音声説明付き画像キャプショニングや、話されたプロンプトからの視覚生成などの統合タスクで高い性能を発揮します。
ベンチマークでは、離散フレームワーク内で非常に競争力があると位置づけられており、しばしば大規模な専門システムに匹敵または接近する性能を示しながら、よりシンプルなアーキテクチャを提供しています。
コミュニティのフィードバックによると、低照度の文書スキャンや混合モーダル対話などの実世界のエッジケースで特に有利であるとされています。
LongCat-Next と従来のマルチモーダルモデルの違い
現在のほとんどのマルチモーダル大規模言語モデル(MLLM)は、言語中心のコアと補助エンコーダに依存しています:
- 視覚データは、アダプタやクロスアテンションを介して LLM の埋め込み空間に投影されます。
- オーディオモジュールはしばしば独立したパイプラインとなります。
これにより、アライメントの問題、レイテンシの増加、トレーニングの不安定性が生じます。
LongCat-Next の利点:
- 統一トークン空間: すべてのモダリティがモデルの「ネイティブ言語」となり、モダリティ間のギャップを減少させます。
- 単一目標: すべてのデータに対する純粋な次トークン予測により、トレーニングとスケーリングが簡素化されます。
- バイアスの低減: 自己回帰を超える追加の帰納的バイアスを最小限に抑えます。
- デプロイの簡便性: 共有バックボーンにより、推論の最適化とマルチモーダルサービングが容易になります。
このパラダイムシフトは、AI が物理世界の絡み合った信号(視覚、音声、テキスト)を一貫した方法で処理することに近づけることを目指しています。
LongCat-Next を始める
アクセスとリソース
- Hugging Face: meituan-longcat/LongCat-Next — モデル重み、safetensors、Transformers統合機能を提供。
- GitHub: 推論コード、モジュール実装、技術レポートPDFを含む完全なリポジトリ。
- デモ: インタラクティブ体験は longcat.chat/longcat-next で利用可能。
- ライセンス: MIT — 研究および商用アプリケーションに適しています。
基本的な使用のヒント
このモデルは標準的なTransformersパイプラインをサポートし、マルチモーダル入力に対応するカスタム拡張機能を備えています。リポジトリからのコード例:
# マルチモーダル推論の疑似コード
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("meituan-longcat/LongCat-Next")

# 混合入力(テキスト+画像+音声)のトークン化
inputs = tokenizer.process_multimodal(prompt, image=image_tensor, audio=audio_tensor)
outputs = model.generate(inputs)
高度なヒント:
- 解像度変更による品質低下を避けるため、任意解像度画像にはdNaViTを活用します。
- 生成タスクでは、クロスモーダル一貫性を微調整するためにトークンレベルの制御を試してみてください。
- コンシューマー向けハードウェアでの展開には、量子化(例: コミュニティリポジトリで入手可能な4ビット版)を使用します。
よくある落とし穴とエッジケース
- トークン予算管理: 高解像度または長時間の音声入力はより多くのトークンを消費します。重要領域を優先するか、圧縮戦略を使用してください。
- クロスモーダル調整: 統合されていますが、複雑なインタリーブタスクでは最適な一貫性を得るために注意深いプロンプトエンジニアリングが必要です。 — 推論最適化: MoEモデルはエキスパート並列性設定の恩恵を受けます。ベストプラクティスについては専用の推論リポジトリを参照してください。
- ハードウェア考慮事項: 完全精度には相当なVRAMが必要です。テストには量子化版から始めてください。
コミュニティの議論を注視して、新興のファインチューニング技術やアプリケーション固有の適応法についての情報を収集しましょう。
潜在的なアプリケーションと将来の展望
LongCat-Nextはより統合されたAIシステムへの扉を開きます:
- 実世界エージェント: 視覚情報を認識し、音声を処理し、単一モデルでマルチモーダルに応答するロボットやアプリ。
- クリエイティブツール: コンテンツ作成のための統一された画像+音声+テキスト生成。
- アクセシビリティ: 音声インタラクションによる強化された文書理解。 -s 物理世界AI: 感覚入力を言語と同じくらい流暢に扱えるモデルへの一歩。
オープンソースリリースとして、開発者が拡張機能、ファインチューニング、ドメイン固有の変種を構築することを促し、マルチモーダルの進歩を加速させます。
結論
LongCat-Nextは、ネイティブマルチモーダルモデリングにおける周到な進歩として際立っています。離散的なオートレグレッシブ(自己回帰)フレームワークの下でモダリティを統一することで、アーキテクチャを簡素化しつつ、視覚、創造、対話において有力な性能を発揮します。
開発者、研究者、そしてAI愛好家にとって、このオープンソースモデルは真のあらゆる入力からあらゆる出力への能力を実験するための実用的な基盤を提供します。Hugging Faceのリポジトリを探索し、技術レポートをレビューし、ライブデモをテストして、DiNAパラダイムを直接体験してください。
今日からLongCat-Nextで構築を始め、統合されたマルチモーダルAIの進化する風景に貢献しましょう。
すぐに始めてみませんか? 公式デモにアクセスするか、GitHubリポジトリをクローンして実験を始めてください。
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.