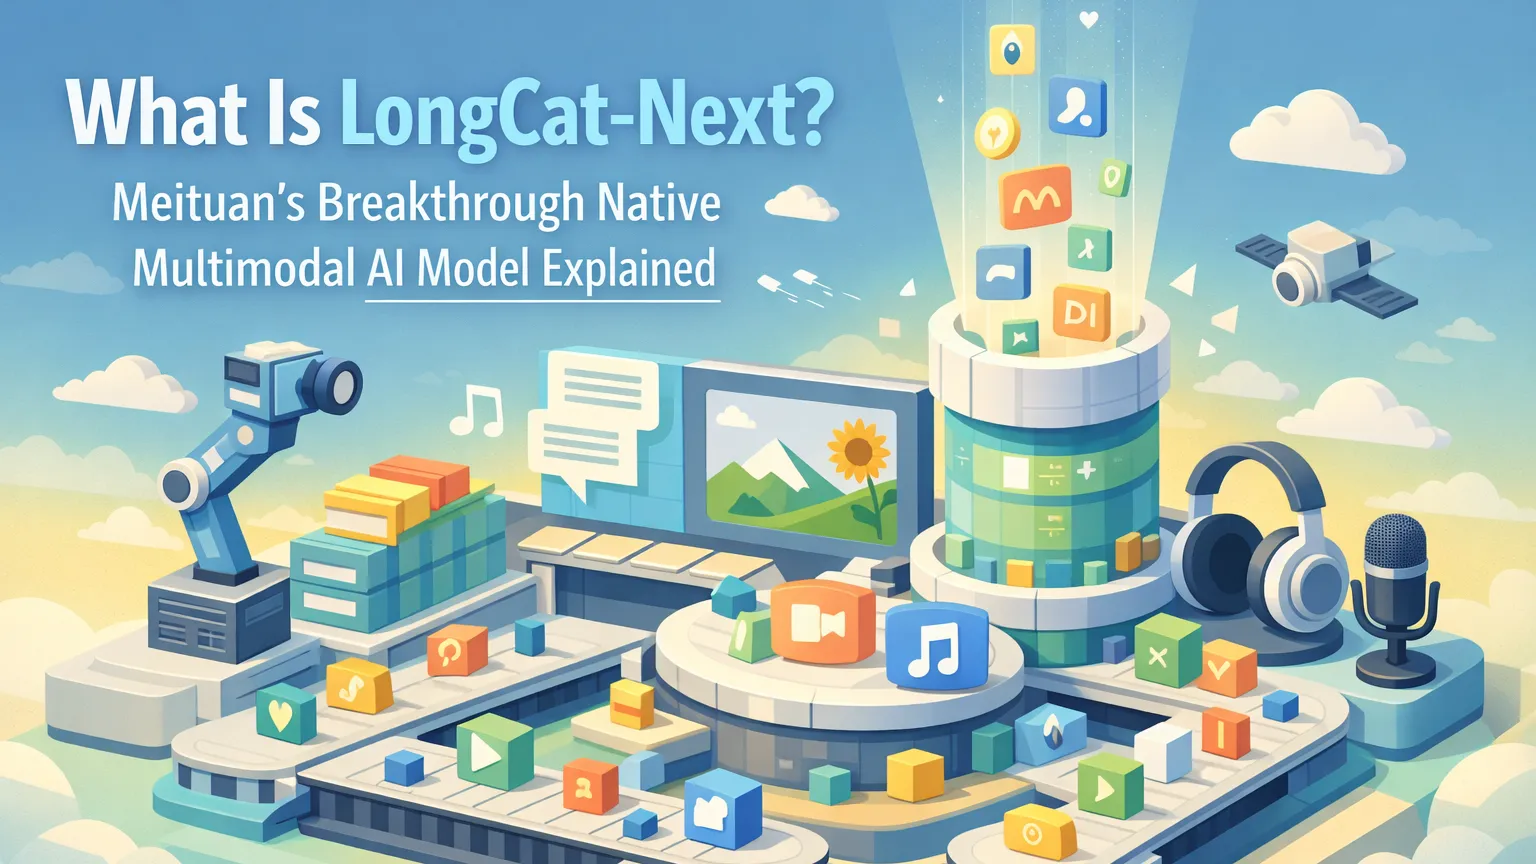
लॉन्गकैट-नेक्स्ट क्या है? मीतुआन के सफलतापूर्वक विकसित मूल बहुमोडल एआई मॉडल की व्याख्या
मुख्य बातें
- LongCat-Next Meituan के LongCat टीम द्वारा विकसित एक ओपन-सोर्स नेटिव मल्टीमोडल फाउंडेशन मॉडल है, जिसे मार्च 2026 में जारी किया गया था।
- यह टेक्स्ट, विज़न (इमेज), और ऑडियो को Discrete Native Autoregression (DiNA) पैराडाइम और नेक्स्ट.टोकन प्रेडिक्शन (NTP) का उपयोग करके एक एकल डिस्क्रीट टोकन स्पेस में एकीकृत करता है।
- LongCat-Flash-Lite MoE बैकबोन (A3B: ~68.5B कुल पैरामीटर, 3B एक्टिव) पर बनाया गया है, यह मिनिमल इंडक्टिव बायस के साथ मोडैलिटीज़ में समझ और जनरेशन का समर्थन करता है।
- मुख्य इनोवेशंस में dNaViT (Discrete Native any-Resolution Vision Transformer) टोकनाइज़र शामिल है, जो क्वालिटी (विशेष रूप से टेक्स्ट रेंडरिंग में) को संरक्षित करते हुए हाई कंप्रेशन (28× तक) सक्षम करता है।
- बेंचमार्क विशेष मॉडलों के खिलाफ विज़ुअल अंडरस्टैंडिंग, इमेज जनरेशन, स्पीच कॉम्प्रिहेंशन, और लो.लेटेंसी वॉइस इंटरैक्शन में प्रतिस्पर्धी परफॉर्मेंस दिखाते हैं।
- Hugging Face और GitHub पर MIT लाइसेंस के तहत पूरी तरह से ओपन-सोर्स किया गया है, जिसमें इनफेरेंस कोड और एक लाइव डेमो उपलब्ध है।
LongCat-Next क्या है?
LongCat-Next मल्टीमोडल AI आर्किटेक्चर में एक महत्वपूर्ण बदलाव का प्रतिनिधित्व करता है। पारंपरिक "पैचवर्क" सिस्टम्स के विपरीत जो विज़न एनकोडर या स्पीच मॉड्यूल को लैंग्वेज मॉडल कोर पर बोल्ट करते हैं, यह मॉडल सभी मोडैलिटीज़ को एक एकीकृत फ्रेमवर्क के भीतर नेटिव एलिमेंट्स के रूप में मानता है।
Meituan की LongCat टीम द्वारा विकसित, LongCat-Next मोडैलिटीज़ को डिस्क्रीट टोकन के रूप में लेक्सिकलाइज़ करता है। इमेज, ऑडियो वेवफॉर्म, और टेक्स्ट को एक शेयर्ड वोकैबुलरी में टोकनाइज़ किया जाता है, जिससे मॉडल उन्हें एक ही ऑटोरेग्रेसिव ऑब्जेक्टिव का उपयोग करके प्रोसेस और जनरेट कर सकता है: अगले टोकन की भविष्यवाणी करना।
यह "Discrete Native Autoregression" (DiNA) दृष्टिकोण लैंग्वेज मॉडलिंग पैराडाइम से परे आर्किटेक्चरल कॉम्प्लेक्सिटी और इंडक्टिव बायसेज़ को कम करता है। परिणाम एक अधिक सुंदर, स्केलेबल सिस्टम है जो सच्ची any-to-any मल्टीमोडल क्षमताओं में सक्षम है।
मुख्य आर्किटेक्चर और तकनीकी नवाचार
Discrete Native Autoregression (DiNA)
अपने मूल में, LongCat-Next सभी मोडैलिटीज़ के लिए नेक्स्ट-टोकन प्रेडिक्शन पैराडाइम का विस्तार करता है। पेयर्ड टोकनाइज़र इनपुट को डिस्क्रीट ID में परिवर्तित करते हैं:
- टेक्स्ट: स्टैंडर्ड सबवर्ड टोकनाइज़ेशन।
- विज़न: dNaViT के माध्यम से प्रोसेस किया गया — एक डिस्क्रीट नेटिव एनी.रिज़ॉल्यूशन विज़न ट्रांसफॉर्मर जो फिक्स्ड पैचिंग या रीसाइजिंग आर्टिफैक्ट्स के बिना वैरिएबल इमेज साइज़ को हैंडल करता है।
- ऑडियो: डिस्क्रीट टोकन में परिवर्तित किया गया जो कॉम्प्रिहेंशन, जनरेशन, और लो-लेटेंसी कन्वर्सेशन का समर्थन करता है।
सभी टोकन एक शेयर्ड MoE (Mixture of Experts) बैकबोन में फीड होते हैं। यह सीमलेस क्रॉस-मोडल रीज़निंग को सक्षम बनाता है, जैसे कि एक इमेज का वर्णन करते हुए संबंधित ऑडियो जनरेट करना या इसके विपरीत।
मॉडल स्केल और दक्षता
- बैकबोन: लगभग 68.5 बिलियन कुल पैरामीटर्स और प्रति इनफरेंस चरण 3 बिलियन सक्रिय पैरामीटर्स वाला LongCat-Flash-Lite MoE।
- दक्षता: समान क्षमता वाले घने मॉडलों की तुलना में असतत टोकन दृष्टिकोण और MoE डिज़ाइन इनफरेंस को हल्का रखते हैं।
- संपीड़न: उच्च संपीड़न अनुपात (जैसे, छवियों के लिए 28×) पर मजबूत जनरेटिव गुणवत्ता प्राप्त करता है, विशेष रूप से उत्पन्न दृश्यों के भीतर सटीक टेक्स्ट रेंडरिंग में उत्कृष्ट प्रदर्शन करता है।
आर्किटेक्चर बहु-मॉडल समझ (जैसे, दृश्य प्रश्नोत्तर, संदर्भ के साथ भाषण लिप्यंतरण) और जनन (जैसे, टेक्स्ट-टू-इमेज, टोकन के माध्यम से इमेज एडिटिंग, वॉयस सिंथेसिस) दोनों का समर्थन करता है।
प्रदर्शन और बेंचमार्क
जारी तकनीकी रिपोर्टों और समुदाय मूल्यांकनों के विश्लेषण से संकेत मिलता है कि LongCat-Next विभिन्न डोमेन में औद्योगिक-स्तरीय परिणाम प्रदान करता है:
- दृश्य समझ: जटिल दृश्यों, दस्तावेजों और किसी भी रिज़ॉल्यूशन इनपुट वाले बेंचमार्कों पर विशेषीकृत विज़न-लैंग्वेज मॉडलों के साथ प्रतिस्पर्धी। यह घने गणितीय सूत्रों, OCR-भारी छवियों और वास्तविक दुनिया की तस्वीरों को प्रभावी ढंग से संभालता है।
- छवि जनन: उच्च निष्ठा और सुसंगतता बनाए रखता है, छवियों के भीतर पठनीय टेक्स्ट रेंडरिंग में उल्लेखनीय शक्ति के साथ — कई बहु-मॉडल सिस्टमों में एक सामान्य कमजोरी।
- ऑडियो/भाषण: उन्नत भाषण समझ, कम-विलंबता वॉयस वार्तालाप और अनुकूलन योग्य वॉयस क्लोनिंग में उत्कृष्ट। यह प्राकृतिक बहु-dमॉडल इंटरैक्शन का समर्थन करता है, जैसे दृश्य सामग्री का संदर्भ लेते हुए बोलना।
- क्रॉस-मॉडल कार्य: एकीकृत कार्यों जैसे ऑडियो विवरण के साथ इमेज कैप्शनिंग या बोले गए प्रॉम्प्ट से दृश्य उत्पन्न करने में मजबूत प्रदर्शन।
बेंचमार्क इसे असतत ढांचों के भीतर अत्यधिक प्रतिस्पर्धी के रूप में स्थिति देते हैं, अक्सर बड़े या विशेषीकृत सिस्टम से मेल खाते या उनके निकट पहुंचते हुए अधिक आर्किटेक्चरल सरलता प्रदान करता है।
समुदाय फीडबैक वास्तविक दुनिया के एज केस में विशेष लाभों का सुझाव देता है, जैसे कम रोशनी वाले दस्तावेज़ स्कैनिंग या मिश्रित-मॉडलता संवाद।
LongCat-Next पारंपरिक बहु-मॉडल मॉडल से कैसे भिन्न है
वर्तमान अधिकांश बहु-मॉडल बड़े भाषा मॉडल (MLLMs) सहायक एनकोडर्स के साथ भाषा1-केंद्रित कोर पर निर्भर करते हैं:
- दृश्य डेटा को एडेप्टर्स या क्रॉस-एटेंशन के माध्यम से LLM के एम्बेडिंग स्पेस में प्रक्षेपित किया जाता है।
- ऑडियो मॉड्यूल अक्सर अलग पाइपलाइन होते हैं।
इससे संरेखण चुनौतियाँ, बढ़ी हुई विलंबता और प्रशिक्षण अस्थिरताएँ पैदा होती हैं।
LongCat-Next के फायदे:
- एकीकृत टोकन स्पेस: सभी मॉडलिटीज़ मॉडल के लिए "मूल भाषा" बन जाती हैं, मॉडलिटी अंतराल को कम करती हैं।
- एकल उद्देश्य: हर चीज में शुद्ध अगले टोकन पूर्वानुमान प्रशिक्षण और स्केलिंग को सरल बनाता है।
- कम पूर्वाग्रह: ऑटोरिग्रेशन के अलावा न्यूनतम अतिरिक्त आगमनात्मक पूर्वाग्रह।
- तैनाती सरलता: साझा बैकबोन इनफरेंस अनुकूलन और बहु-मॉडल परोसने को आसान बनाता है।
यह प्रतिमान बदलाव AI को भौतिक दुनिया के अंतर्गुम्फित संकेतों (दृष्टि, ध्वनि, टेक्स्ट) को सामंजस्यपूर्ण तरीके से संभालने के करीब लाने का लक्ष्य रखता है।
LongCat-Next के साथ शुरुआत करना
पहुँच और संसाधन
- हगिंग फेस: meituan-longcat/LongCat-Next — मॉडल वेट्स, सुरक्षित टेंसर और ट्रांसफॉर्मर्स इंटीग्रेशन।
- गिटहब: इनफेरेंस कोड, मॉड्यूलर कार्यान्वयन और तकनीकी रिपोर्ट PDF सहित पूरा रिपॉजिटरी।
- डेमो: इंटरैक्टिव अनुभव longcat.chat/longcat-next पर।
- लाइसेंस: MIT — शोध और वाणिज्यिक अनुप्रयोगों के लिए उपयुक्त।
बेसिक उपयोग टिप्स
मॉडल मल्टीमोडल इनपुट्स के लिए कस्टम एक्सटेंशन के साथ मानक ट्रांसफॉर्मर्स पाइपलाइन को सपोर्ट करता है। उदाहरण कोड पैटर्न (रिपॉजिटरी से):
# मल्टीमोडल इनफेरेंस के लिए स्यूडोकोड
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("meituan-longcat/LongCat-Next")

# मिश्रित इनपुट्स को टोकनाइज़ करें (टेक्स्ट + इमेज + ऑडियो)
inputs = tokenizer.process_multimodal(prompt, image=image_tensor, audio=audio_tensor)
outputs = model.generate(inputs)
एडवांस टिप्स:
- री-साइज़िंग से गुणवत्ता हानि से बचने के लिए किसी भी रिज़ॉल्यूशन की छवियों के लिए dNaViT का लाभ उठाएँ।
- जनरेशन कार्यों के लिए, बेहतर क्रॉस-मोडल संगति के लिए टोकन-y स्तरीय नियंत्रण के साथ प्रयोग करें।
- कंज्यूमर हार्डवेयर डिप्लॉयमेंट के लिए क्वांटाइजेशन का उपयोग करें (उदाहरण के लिए, कम्युनिटी रिपॉजिटरी में उपलब्ध 4-बिट वर्जन)।
सामान्य समस्याएँ और एज केस
- टोकन बजट प्रबंधन: उच्च-रिज़ॉल्यूशन या लंबे ऑडियो इनपुट अधिक टोकन खपत करते हैं; प्रमुख क्षेत्रों को प्राथमिकता दें या संपीड़न रणनीतियों का उपयोग करें।
- क्रॉस-मोडल संरेखण: एकीकृत होने के बावजूद, जटिल इंटरलीव कार्यों के लिए इष्टतम संगति के लिए सावधानी से प्रॉम्प्ट इंजीनियरिंग की आवश्यकता हो सकती है।
- इनफेरेंस ऑप्टिमाइजेशन: MoE मॉडल एक्सपर्ट-समानांतर सेटअप से लाभ उठाते हैं; सर्वोत्तम प्रथाओं के लिए समर्पित इनफेरेंस रिपॉजिटरी देखें।
- हार्डवेयर विचार: पूरी प्रेसिजन के लिए पर्याप्त VRAM की आवश्यकता होती है; टेस्टिंग के लिए क्वांटाइज्ड वेरिएंट से शुरू करें।
उभरती हुई फाइन--ट्यूनिंग तकनीकों और अनुप्रयोग-विशिष्ट अनुकूलनों के लिए कम्युनिटी चर्चाओं पर नज़र रखें।
संभावित अनुप्रयोग और भविष्य के निहितार्थ
LongCat-Next अधिक एकीकृत एआई सिस्टम के लिए द्वार खोलता है:
- वास्तविक-विश्व एजेंट: ऐसे रोबोट या ऐप जो दृश्यों को देखते हैं, भाषण को प्रोसेस करते हैं और एक मॉडल में मल्टीमोडल तरीके से प्रतिक्रिया देते हैं।
- रचनात्मक टूल: सामग्री निर्माण के लिए एकीकृत इमेज+ऑडियो+टेक्स्ट जनरेशन।
- पहुँच: वॉइस इंटरैक्शन के साथ उन्नत दस्तावेज़ समझ।
- भौतिक-विश्व एआई: ऐसे मॉडल की ओर एक कदम जो संवेदी इनपुट्स को भाषा की तरह सहजता से समझते हैं।
एक ओपन-सोर्स रिलीज़ के रूप में, यह डेवलपर्स को एक्सटेंशन, फाइन-ट्यून और डोमेन-L किस्में बनाने के लिए आमंत्रित करता है, जिससे मल्टीमोडल प्रगति में तेजी आती है।
निष्कर्ष
LongCat-Next स्थानीय बहुमोडल मॉडलिंग में एक सावधानीपूर्वक प्रगति के रूप में उभरता है। एक अलग ऑटोरेग्रेसिव फ्रेमवर्क के तहत मोडलिटी को एकीकृत करके, यह आर्किटेक्चर को सरल बनाता है साथ ही देखने, बनाने और बात करने में सक्षम प्रदर्शन प्रदान करता है।
डेवलपर्स, शोधकर्ताओं और AI उत्साही लोगों के लिए, यह ओपन-सोर्स मॉडल वास्तविक किसी-से-किसी क्षमताओं के साथ प्रयोग करने के लिए एक व्यावहारिक आधार प्रदान करता है। DiNA प्रतिमान को प्रत्यक्ष रूप से अनुभव करने के लिए Hugging Face रिपॉजिटरी का पता लगाएं, तकनीकी रिपोर्ट की समीक्षा करें और लाइव डेमो का परीक्षण करें।
आज ही LongCat-Next के साथ निर्माण शुरू करें और एकीकृत बहुमोडल AI के विकसित होते परिदृश्य में योगदान दें।
गोता लगाने के लिए तैयार हैं? आधिकारिक डेमो पर जाएं या GitHub रेपो को क्लोन करके प्रयोग शुरू करें।
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.