
Andrej Karpathy 如何運用大型語言模型在 Obsidian 中建立動態個人知識庫
重點摘要
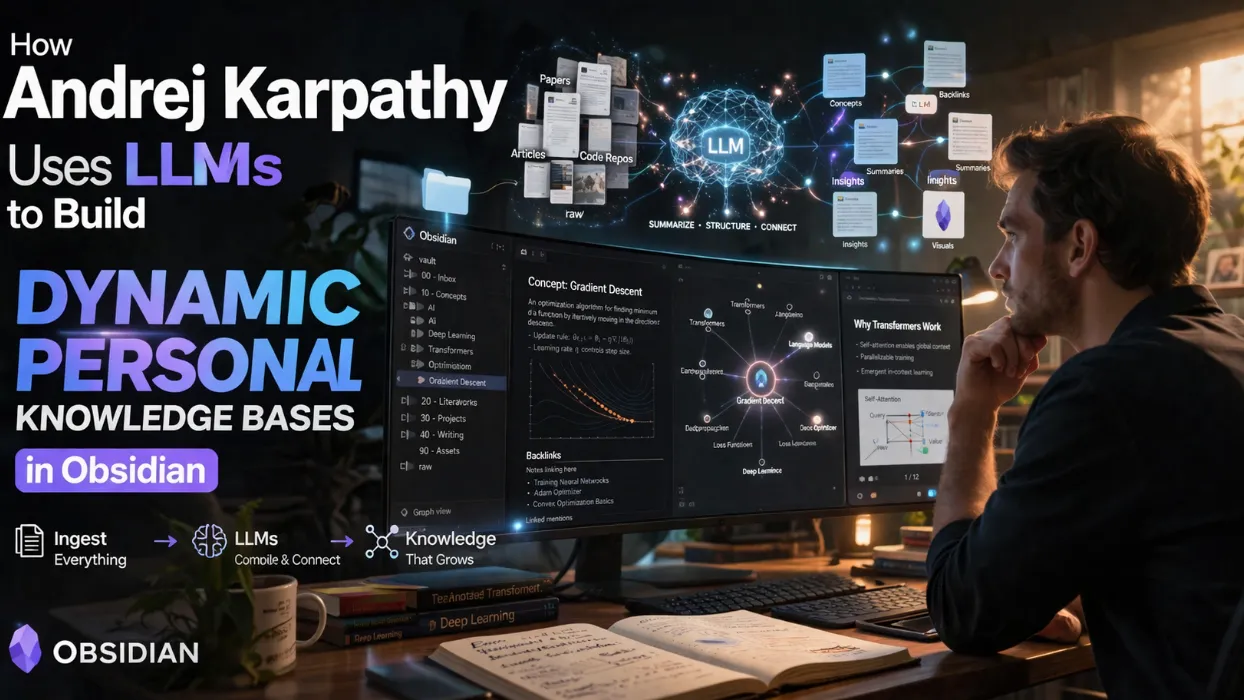
- Andrej Karpathy 的系統會將原始文件(論文、文章、倉庫、圖片)攝取至
raw/目錄,然後利用 LLM 逐步將它們編譯成結構化的 Markdown 維基百科,包含摘要、反向連結、概念文章和相互關聯。 - Obsidian 作為輕量級前端,用於查看原始資料、編譯後的維基,以及生成的輸出,如 Marp 簡報或 Matplotlib 圖表;LLM 幾乎處理了所有的書寫與維護工作。
- 在規模擴大時(約 100 篇文章,約 40 萬字),複雜的問答能以最低限度的 RAG 依賴進行;LLM 自動維護索引和摘要,以實現高效的上下文檢索。
- 透過 LLM 運行健康檢查來進行代碼整理(linting),識別不一致之處、估算遺漏資料、建議關聯,並提出新文章,以確保資料完整性。
- 輸出不僅限於文字,還包括渲染後的 Markdown、簡報、視覺化圖表或動態 HTML,這些輸出通常會存回維基中,隨著時間累積知識。
- 社群採用後,延伸出像是將代理分離以避免污染控制、合成資料用於微調,以及針對每個查詢生成暫存維基等擴展功能。
從程式碼到知識操作的轉變
分析顯示 token 分配方式發生了根本性變化:近期的前沿 LLM 在知識綜合方面的表現優於純粹的程式碼生成。Karpathy 報告指出,現在他的 token 吞吐量中有很大一部分是用於操作儲存為 Markdown 文件和圖片的結構化知識,而非處理暫存的終端輸出。
這個工作流程將被動的研究消費轉變為一個主動、自我完善的知識庫。原始資料積累在一個專用目錄中,LLM 接著逐步「編譯」它們——生成摘要、將內容分類至概念、編寫連結文章,並建立反向連結。
來自類似個人系統的基準測試表明,一旦維基百科達到關鍵規模,查詢複雜度會急劇增加,而檢索開銷並不會按比例上升。
資料攝取與編譯流程
該處理流程從定向收集開始:
- 來源處理:研究論文、文章、GitHub 倉庫、資料集和圖片進入
raw/目錄。網路內容透過 Obsidian Web Clipper 轉換為 Markdown,圖片則下載至本地以供 LLM 直接參考。 - 逐步編譯:LLM 最初逐個處理新文件,隨後為了效率而進行模式匹配。類似「將這個新文件歸檔至我們的維基」的指令會觸發分類、摘要生成和連結建立。
- 結構建立:最終生成的維基具有以下特點:
- 每份文件的摘要
- 概念層級的文章
- 雙向反向連結
- 基於目錄的組織
社群回饋建議,對於較大量的攝取,批次處理或多階段流程可以改善目錄決策,但 Karpathy 在早期階段保持人機協作以確保品質。
Obsidian 作為理想的前端界面
Obsidian 扮演著系統中的極簡版「IDE」:
- 同時檢視原始資料、編譯後的維基頁面及視覺化圖表。
- 透過 Marp 等插件,可直接將 LLM 生成的 Markdown 渲染為簡報投影片。
- 圖譜視圖與反向連結導航,能揭示新興的關聯脈絡。
專家指出,Obsidian 以本地優先的 Markdown 為基礎,既能最小化平台鎖定風險,又能支援自訂工具。雖然存在 VS Code 搭配 Markdown 擴充功能等替代方案,但 Obsidian 的生態系統更能加速視覺化與互動式探索。
社群實踐中浮現出分離策略:維護一個高信號的個人知識庫,同時建立一個供 AI 代理使用的「雜亂」知識庫,以防止生成內容造成污染。
進階問答與輸出生成
當系統擴展後,維基支援複雜查詢:
- LLM 能瀏覽完整內容庫,利用自行維護的索引與摘要。
- 在約 40 萬字規模下,上下文視窗能高效處理相關集群,無需依賴繁重的向量 RAG。
- 輸出形式依需求調整:Markdown 報告、Marp 簡報、Matplotlib 圖表,甚至動態 HTML/JS 用於互動式篩選與視覺化。
生成的成果常回饋至維基,形成複利循環:探索過程持續強化未來查詢。Lex Fridman 與其他使用者回報類似設置,用於播客研究或透過臨時迷你維基進行即時語音互動。
LLM 驅動的檢查與維護
系統的突出特色是自動化「健康檢查」:
- 偵測數週前擷取來源間不一致的主張。
- 利用網路搜尋工具填補資訊缺口。
- 識別新穎關聯與潛在文章主題。
- 建議追蹤問題以深化覆蓋範圍。
這使維基從靜態儲存庫轉變為活躍的研究夥伴。隨著規模增長,過時資料風險上升;版本化稽核與增量更新,比一次性擷取更能有效緩解資訊漂移。
新興工具與未來探索
使用者延伸核心功能的方式:
- 自訂 CLI 或簡易搜尋引擎,作為工具提供給 LLM 使用。
- 合成資料生成搭配微調,將維基知識嵌入模型權重。
- 暫態維基生成:單一查詢在最終報告前,能產出完整、經檢查、迭代的知識庫——遠超單純解碼範疇。
社群分享的架構圖表,視覺化從擷取、編譯、查詢到強化的各階段。為非開發者銜接此流程的產品具明確商機,因每個組織皆存有未經整理的「原始/」資料等待編譯。
與傳統 PKM(個人知識管理)的比較凸顯優勢:在活躍研究領域,LLM 自動化將人工整理負擔降低 80–90%,同時反向連結與圖譜能呈現人類可能忽略的洞察。
挑戰與最佳實踐
- 規模管理:摘要內容會過時;應優先處理最新差異並定期稽核。
- 污染控制:在驗證前隔離智慧體產生的內容。
- 漸進採用:從小規模開始,讓模式自然浮現,再逐步邁向全面自動化。
- 工具簡化:使用扁平化的 Markdown 目錄結構搭配
AGENTS.md結構描述即可;過度設計只會延遲價值實現。
可行建議:從一個研究主題開始。蒐集 10-20 個資料來源,透過大語言模型編譯初始知識庫,再透過反覆提問與程式碼檢查進行迭代。透過查詢深度與相較傳統搜尋/筆記方法所節省的時間,來衡量價值實現程度。
結論
Andrej Karpathy 的大語言模型驅動知識庫工作流程,標誌著研究人員與實踐者資訊互動方式的實質演進。將編譯、維護與綜合分析工作委託給能力強大的模型,同時保留 Obsidian 的直覺互動介面,讓使用者能用更低阻力達成更深入的知識理解。
這種方法能隨時間產生複利效應:每次查詢都能強化知識基底,每次程式檢查都能提升完整性。隨著尖端模型持續進化,可預期將出現更多能從自然提問自動建立完整臨時知識庫的工具。
今天就從最小可行版本開始實踐——導入你下一批研究資料,讓大語言模型建立知識基礎。從被動吸收知識轉為主動培育知識的轉變,可能在智慧體時代重塑個人與組織的智慧模式。
從小處著手,堅持迭代,見證你的個人知識庫逐步蛻變為真正的智慧倍增器。
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.

viewmax mcp
MCP ServersViewMax MCP is a hosted Streamable HTTP MCP server for generating AI video, images, music, speech, and sound effects, with tools for model discovery, task polling, and credit checks. Official setup is documented for Claude Web/Desktop, Claude Code, Cursor, Codex, and SDK clients.
TinyFish
MCP ServersTinyFish is a web infrastructure platform for AI agents that combines live web search, browser-rendered content extraction, goal-based web automation, and managed cloud browser sessions. Developers can access the platform through APIs, SDKs, a CLI, and integrations with agent frameworks and AI coding tools.