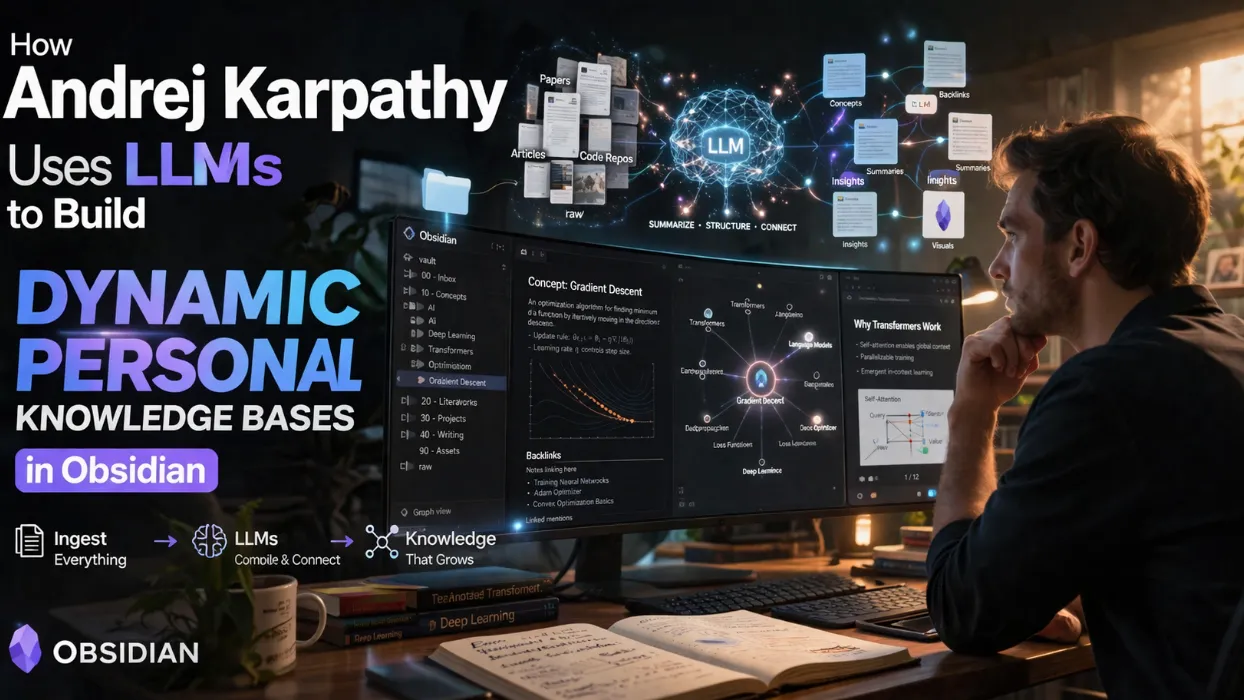
Andrej Karpathy कैसे LLMs का उपयोग करके Obsidian में गतिशील व्यक्तिगत ज्ञान आधार बनाते हैं
मुख्य बिंदु
- आंद्रेज कारपथी की प्रणाली कच्चे दस्तावेज़ों (पेपर्स, लेख, रेपोस, चित्र) को
raw/निर्देशिका में इनपुट करती है, फिर LLMs का उपयोग करके उन्हें संक्षेप, बैकलिंक्स, संकल्पना लेख और अंतर्संबंधों के साथ एक संरचित मार्कडाउन विकी में क्रमिक रूप से संकलित करती है। - ओब्सीडियन कच्चे डेटा, संकलित विकी और मार्प स्लाइड्स या मैटप्लॉटलिब प्लॉट्स जैसे उत्पन्न आउटपुट्स को देखने के लिए हल्के फ्रंटएंड के रूप में कार्य करता है, जबकि LLM लगभग सभी लेखन और रखरखाव संभालता है।
- बड़े पैमाने पर (~100 लेख, ~400K शब्द), जटिल Q&A न्यूनतम RAG निर्भरता के साथ होता है; LLM कुशल संदर्भ पुनर्प्राप्ति के लिए इंडेक्स और सारांशों का स्वतः रखरखाव करता है।
- LLM स्वास्थ्य जाँच के माध्यम से लिंटिंग विसंगतियों की पहचान करती है, गायब डेटा का अनुमान लगाती है, संबंध सुझाती है और नए लेख प्रस्तावित करती है, जिससे डेटा अखंडता सुनिश्चित होती है।
- आउटपुट पाठ से आगे बढ़कर रेंडर किए गए मार्कडाउन, स्लाइड्स, विज़ुअलाइज़ेशन या डायनामिक HTML तक फैलते हैं, जिन्हें अक्सर समय के साथ ज्ञान को बढ़ाने के लिए विकी में वापस फाइल किया जाता है।
- समुदाय अपनाने से संदूषण नियंत्रण के लिए एजेंट पृथक्करण, फ़ाइन-ट्यूनिंग के लिए सिंथेटिक डेटा और प्रति क्वेरी उत्पन्न क्षणिक विकी जैसे एक्सटेंशन उभरते हैं।
कोड से ज्ञान प्रबंधन की ओर बदलाव
विश्लेषण से पता चलता है कि टोकन आवंटन में एक मूलभूत परिवर्तन हुआ है: हाल के फ्रंटियर LLMs शुद्ध कोड जनरेशन की तुलना में ज्ञान संश्लेषण में उत्कृष्ट हैं। कारपथी रिपोर्ट करते हैं कि उनके टोकन थ्रूपुट का एक बड़ा हिस्सा अब क्षणिक टर्मिनल आउटपुट्स के बजाय मार्कडाउन फ़ाइलों और चित्रों के रूप में संग्रहीत संरचित ज्ञान का प्रबंधन करता है।
यह वर्कफ़्लो निष्क्रिय शोध उपभोग को एक सक्रिय, स्वयं-सुधारने वाले ज्ञान आधार में बदल देता है। कच्चे स्रोत एक समर्पित निर्देशिका में जमा होते हैं। एक LLM फिर उन्हें क्रमिक रूप से "संकलित" करता है—सारांश उत्पन्न करना, सामग्री को संकल्पनाओं में वर्गीकृत करना, लिंक किए गए लेख लिखना और बैकलिंक्स स्थापित करना।
समान व्यक्तिगत प्रणालियों के बेंचमार्क इंगित करते हैं कि एक बार विकी महत्वपूर्ण मात्रा तक पहुँच जाती है, तो क्वेरी जटिलता पुनर्प्राप्ति ओवरहेड में आनुपातिक वृद्धि के बिना नाटकीय रूप से स्केल होती है।
डेटा अंतर्ग्रहण और संकलन प्रक्रिया
पाइपलाइन लक्षित संग्रह से शुरू होती है:
- स्रोत हैंडलिंग: शोध पेपर्स, लेख, GitHub रेपोस, डेटासेट और चित्र
raw/में पहुँचते हैं। वेब सामग्री ओब्सीडियन वेब क्लिपर के माध्यम से मार्कडाउन में परिवर्तित होती है, जिसमें चित्र सीधे LLM संदर्भ के लिए स्थानीय रूप से डाउनलोड किए जाते हैं। - क्रमिक संकलन: LLMs नए दस्तावेज़ों को शुरू में एक-एक करके प्रोसेस करते हैं, फिर दक्षता के लिए पैटर्न-मिलान करते हैं। "इस नए दस्तावेज़ को हमारी विकी में फाइल करें" जैसे निर्देश वर्गीकरण, सारांशीकरण और लिंकिंग को ट्रिगर करते हैं।
- संरचना निर्माण: परिणामी विकी में निम्नलिखित विशेषताएँ होती हैं:
- प्रति-दस्तावेज़ सारांश
- संकल्पना-स्तरीय लेख
- द्विदिश बैकलिंक्स
- निर्देशिका-आधारित संगठन
समुदाय फीडबैक से पता चलता है कि बैच प्रोसेसिंग या मल्टी.स्टेज पाइपलाइन्स बड़े अंतर्ग्रहणों के लिए निर्देशिका निर्णयों को सुधारती हैं, हालाँकि कारपथी गुणवत्ता के लिए प्रारंभिक चरणों में मानव-इन-द-लूप रखते हैं।
ऑब्सीडियन एक आदर्श फ्रंटएंड के रूप में
ऑब्सीडियन सिस्टम के लिए एक न्यूनतम "आईडीई" के रूप में कार्य करता है:
- रॉ स्रोतों, संकलित विकी और विज़ुअलाइज़ेशन का एक साथ दृश्य।
- मार्प जैसे प्लगइन एलएलएम-जनित मार्कडाउन से सीधे स्लाइड रेंडरिंग सक्षम करते हैं।
- ग्राफ दृश्य और बैकलिंक नेविगेशन उभरते कनेक्शन प्रकट करते हैं।
विशेषज्ञ ध्यान देते हैं कि ऑब्सीडियन का स्थानीय-Wपहला मार्कडाउन आधार लॉक-इन को कम करता है जबकि कस्टम टूल्स का समर्थन करता है। मार्कडाउन एक्सटेंशन वाले वीएस कोड जैसे विकल्प मौजूद हैं, लेकिन ऑब्सीडियन का इकोसिस्टम दृश्य और इंटरैक्टिव अन्वेषण को तेज करता है।
समुदाय कार्यान्वयनों में पृथक्करण रणनीतियाँ उभरती हैं: जनरेटेड सामग्री से दूषित होने से बचने के लिए एक उच्च-
उन्नत प्रश्न-उत्तर और आउटपुट जनरेशन
स्केल होने के बाद, विकी परिष्कृत क्वेरी का समर्थन करती है:
- एलएलएम पूर्ण कॉर्पस को नेविगेट करते हैं, स्व-निर्मित सूचकांक और सारांश का लाभ उठाते हैं।
- ~400K शब्दों पर, संदर्भ विंडोज़ संबंधित क्लस्टर को भारी वेक्टर रैग के बिना कुशलतापूर्वक संभालती हैं।
- आउटपुट ज़रूरतों के अनुकूल होते हैं: मार्कडाउन रिपोर्ट, मार्प स्लाइडशो, मैटप्लॉटलिब फिगर, या इंटरैक्टिव फ़िल्टरिंग और विज़ुअलाइज़ेशन के लिए गतिशील HTML/JS भी।
जनरेटेड आर्टिफैक्ट्स अक्सर विकी में वापस फीड होते हैं, एक चक्रवृद्धि लूप बनाते हैं जहां अन्वेषण भविष्य की क्वेरी को बढ़ाते हैं। लेक्स फ्रीडमैन और अन्य पॉडकास्ट शोध या अस्थायी मिनी.विकी के माध्यम से चलते-फिरते आवाज़ इंटरैक्शन के लिए समान सेटअप रिपोर्ट करते हैं।
एलएलएम-ड्रिवन लिंटिंग और रखरखाव
एक उल्लेखनीय विशेषता स्वचालित "स्वास्थ्य जांच" है:
- सप्ताहों के अंतर में इनजेस्ट किए गए स्रोतों में असंगत दावों का पता लगाएं।
- वेब खोज टूल का उपयोग करके अंतराल का अनुमान लगाएं।
- नए कनेक्शन और उम्मीदवार लेखों की पहचान करें।
यह विकी को एक स्थिर भंडार से एक जीवंत शोध भागीदार में बदल देता है। वृद्धि के साथ स्टेल डेटा जोखिम बढ़ता है; संस्करणित ऑडिट और वृद्धिशील अपडेट एक बार के इनजेस्ट की तुलना में ड्रिफ्ट को अधिक प्रभावी ढंग से कम करते हैं।
उभरते टूल्स और भविष्य के अन्वेषण
उपयोगकर्ता कोर का विस्तार करते हैं:
- कस्टम सीएलआई या सरल खोज इंजन एलएलएम को टूल के रूप में सौंपे गए।
- विकी ज्ञान को मॉडल वेट में एम्बेड करने के लिए फाइन-ट्यूनिंग के साथ जोड़ा गया सिंथेटिक डेटा जनरेशन।
- क्षणिक विकी जनरेशन: एक एकल क्वेरी अंतिम रिपोर्टिंग से पहले एक पूर्ण, लिंटेड, पुनरावृत्त ज्ञान आधार उत्पन्न करती है—सरल डिकोडिंग से कहीं आगे।
समुदाय में साझा किए गए आर्किटेक्चरल डायग्राम इनजेस्ट से लेकर कंपाइलेशन, क्वेरी और एनहांसमेंट तक के चरणों को दृश्यात्मक बनाते हैं। गैर-डेवलपर्स के लिए इसे पाटने वाले उत्पाद एक स्पष्ट अवसर प्रस्तुत करते हैं, क्योंकि प्रत्येक संगठन संकलन की प्रतीक्षा कर रहे असंरचित "रॉ/" डेटा को बनाए रखता है।
पारंपरिक PKM (पर्सनल नॉलेज मैनेजमेंट) से तुलना फायदे उजागर करती है: एलएलएम ऑटोमेशन सक्रिय शोध डोमेन में मैन्युअल क्यूरेशन को 80-90% कम कर देता है, जबकि बैकलिंक और ग्राफ वह अंतर्दृष्टि सतह करते हैं जो मनुष्यों को याद आ सकती है।
चुनौतियाँ और सर्वोत्तम प्रथाएँ
- स्केल प्रबंधन: सारांश अप्रासंगिक हो सकते हैं; ताजा अंतर (डिफ़्स) और ऑडिट्स को प्राथमिकता दें।
- दूषितता नियंत्रण: एजेंट-जनित सामग्री को जाँचे जाने तक अलग रखें।
- वृद्धिशील अपनाना: छोटी शुरुआत करें, पूर्ण स्वायत्तता से पहले पैटर्न उभरने दें।
- टूलिंग सादगी:
AGENTS.mdस्कीमा के साथ फ्लैट मार्कडाउन निर्देशिकाएँ पर्याप्त हैं; अतिरिक्त इंजीनियरिंग मूल्य में देरी करती है।
कार्रवाई योग्य अंतर्दृष्टि: एक शोध विषय से शुरू करें। 10-20 स्रोत इकट्ठा करें, एक LLM को प्रारंभिक विकी संकलित करने के लिए प्रॉम्प्ट करें, फिर प्रश्नों और लिंटिंग को पुनरावृत्त करें। मूल्य को पारंपरिक खोज/नोट-लेने के मुकाबले प्रश्न की गहराई और बचाए गए समय से मापें।
निष्कर्ष
आंद्रेज कार्पथी का LLM-संचालित ज्ञान आधार वर्कफ़्लो शोधकर्ताओं और व्यवसायियों के सूचना के साथ संवाद करने के तरीके में एक व्यावहारिक विकास का प्रतीक है। संकलन, रखरखाव और संश्लेषण को सक्षम मॉडलों को सौंपते हुए ओब्सीडियन को सहज अंतरक्रिया के लिए बनाए रखने से, उपयोगकर्ता कम घर्षण के साथ गहरी समझ हासिल करते हैं।
यह दृष्टिकोण समय के साथ बढ़ता है: हर प्रश्न आधार को मजबूत करता है, हर लिंटिंग पास अखंडता बढ़ाता है। जैसे-जैसे फ्रंटियर मॉडल आगे बढ़ेंगे, प्राकृतिक प्रश्नों से संपूर्ण क्षणिक विकियों को स्वचालित करने वाले व्यापक टूल्स की अपेक्षा करें।
आज ही एक न्यूनतम संस्करण लागू करें—अपनी अगली शोध बैच को इनजेस्ट करें और एक LLM को नींव बनाने दें। ज्ञान का उपभोग करने से सक्रिय रूप से उसका संवर्धन करने की ओर यह बदलाव एजेंटिक युग में व्यक्तिगत और संगठनात्मक बुद्धिमत्ता को पुनः परिभाषित कर सकता है।
छोटी शुरुआत करें, निरंतर पुनरावृत्त करें, और अपनी व्यक्तिगत विकी को एक वास्तविक बौद्धिक गुणक में विकसित होते देखें।
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
PaidSync.ai
MCP ServersPaidSync.ai is a hosted MCP server for paid advertising that exposes 610+ tools across 14 advertising, analytics, tagging, and commerce platforms. It supports read/write workflows from AI clients including ChatGPT, Claude, Gemini, Cursor, Claude Code, and Codex, with a free plan.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.