
Pourquoi la traduction est-elle lente après la connexion à OpenRouter ? Principales causes et solutions rapides 2026
Principaux enseignements
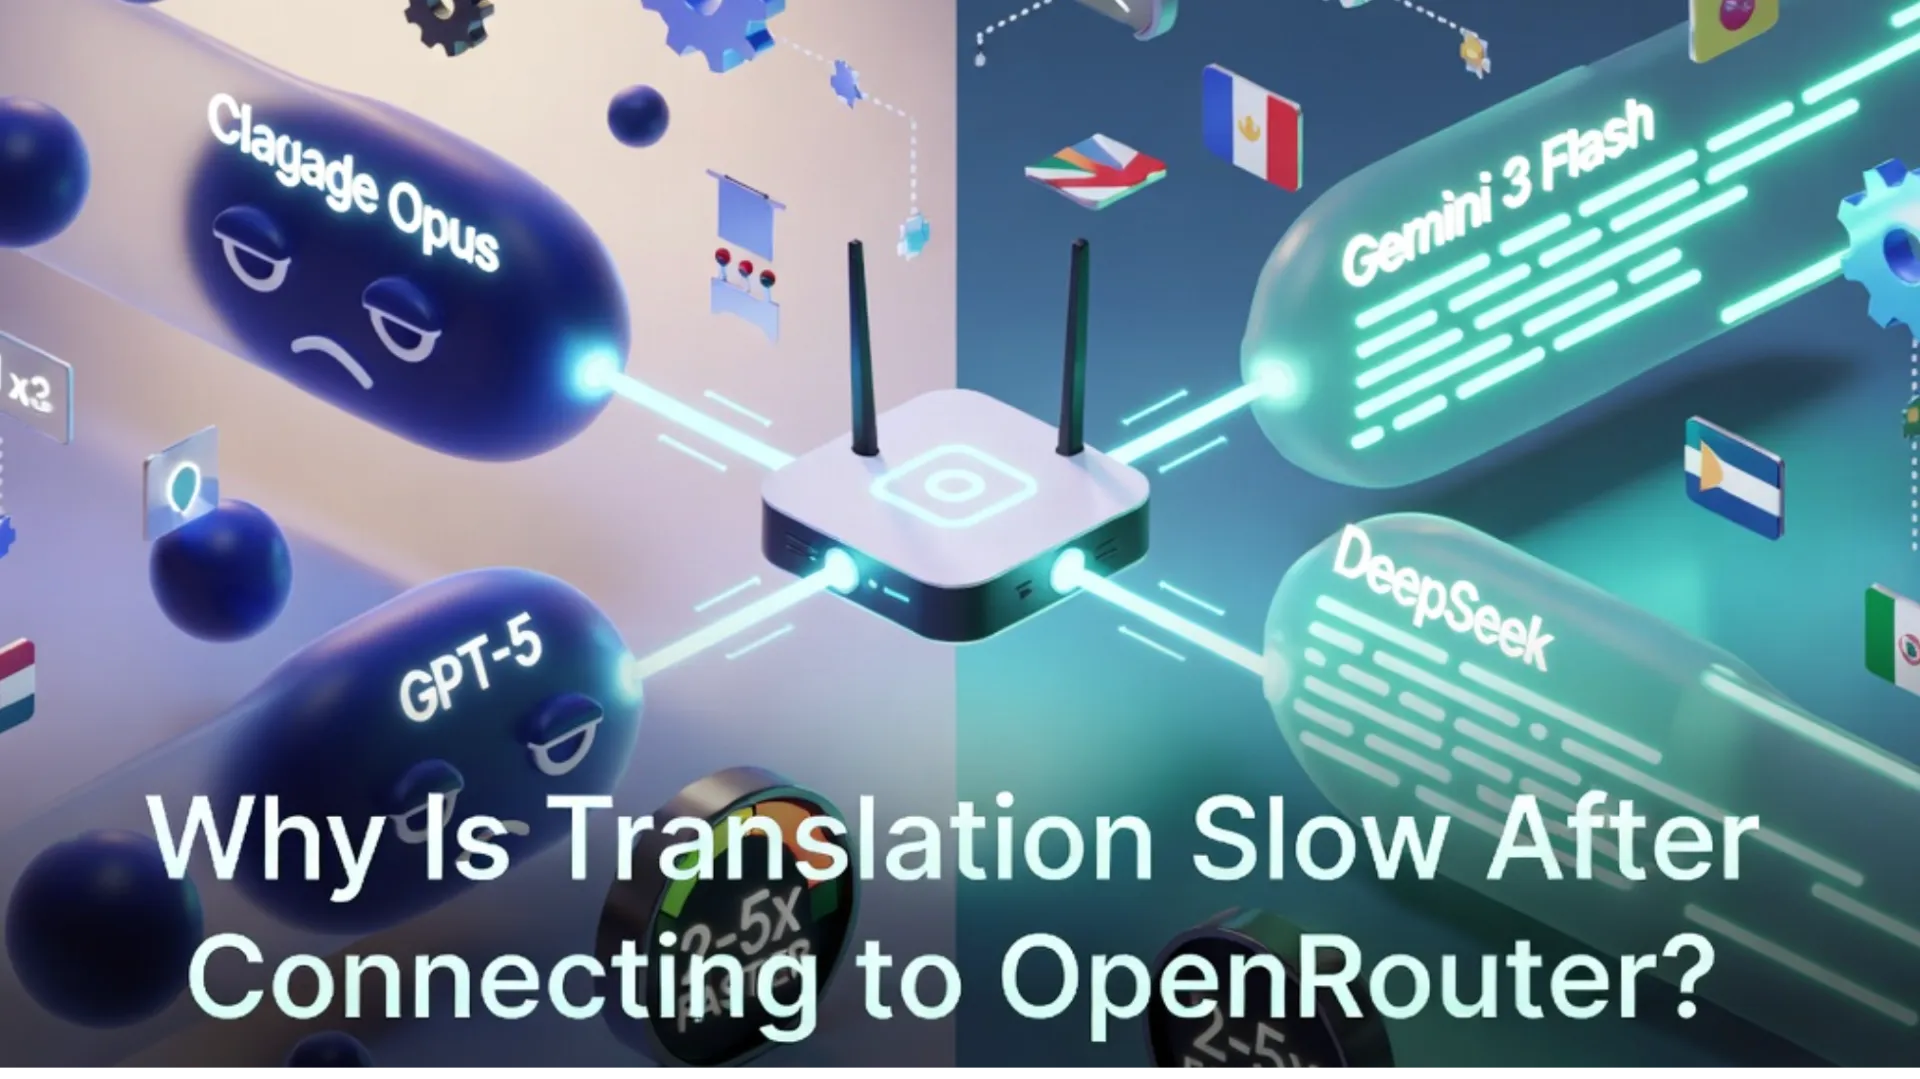
- La principale cause de lenteur dans les traductions sur OpenRouter est l'utilisation de modèles intrinsèquement lents (Claude Opus/Sonnet, classe GPT-5, Gemini Pro) plutôt que des modèles rapides.
- Le routage par défaut privilégie le coût plutôt que la vitesse — changer pour la Latence (la plus faible d'abord) améliore souvent les performances immédiatement.
- Une mauvaise gestion des lots (appels en série, pas de diffusion en continu (streaming), prompts longs non découpés, température élevée) est extrêmement fréquente et facile à corriger.
- Un faible solde de crédits et un cache froid (cold cache) lors des premières requêtes contribuent aussi de manière significative.
- Passer à des modèles rapides comme Gemini 3 Flash, DeepSeek V3/V4, Qwen3, ou Mistral Small peut rendre la traduction 2 à 5 fois plus rapide tout en maintenant une bonne qualité pour la plupart des cas d'usage.
Principales causes de lenteur dans les traductions sur OpenRouter (classées par fréquence)
1. Utilisation d'un modèle lent (cause la plus fréquente)
De nombreux utilisateurs se connectent à OpenRouter et continuent d'utiliser des modèles de haute qualité mais lents : .
-D Claude Opus / Sonnet 4.x : Meilleure qualité, mais une inférence nettement plus lente, surtout sur les textes longs. Plus le contexte est long, plus le ralentissement est marqué.
- Modèles de la classe Gemini Pro / GPT-5 : Excellente qualité mais souffrent de longues files d'attente pendant les heures de pointe.
Solution : Passez à des modèles plus rapides optimisés pour la vitesse :
- Gemini 3 Flash (ou Flash Lite)
- DeepSeek V3 / V4
- Qwen3-235B
- Mistral Small
Ces modèles sont généralement 2 à 5 fois plus rapides sur les tâches de traduction et offrent une qualité suffisante pour un usage quotidien, les documents, les romans visuels et la plupart des travaux professionnels.
2. Stratégie de routage par défaut ne priorisant pas la vitesse
Même pour un modèle identique, OpenRouter dispose de multiples fournisseurs backend. Par défaut, il choisit souvent le fournisseur disponible le moins cher, qui peut être plus lent ou très sollicité.
Solutions :
- Dans le Tableau de bord OpenRouter → Paramètres → Routage, changez le Tri par défaut du fournisseur en Latence (la plus faible d'abord).
- Dans votre requête API, ajoutez des paramètres de routage :
{
  "model": "google/gemini-3-flash",
  "provider": {
    "sort": "latency"
  },
  "stream": true
}
Cela force OpenRouter à choisir le backend disponible le plus rapide pour votre requête.
3. Traitement par lots sous-optimal (très fréquent)
- -Faire des appels de traduction en série plutôt qu'en parallèle (pas de ThreadPool ou asyncio)
- Envoyer des prompts très longs + des documents complets en une seule requête sans découpage
- Paramètres de température élevés (la traduction fonctionne mieux à temperature=0.2~0.3)
- Ne pas utiliser la diffusion en continu (streaming) — le client attend la réponse complète avant d'afficher quoi que ce soit
Solutions :
- Utilisez un traitement parallèle avec asyncio ou concurrent.futures
- Divisez les textes longs en morceaux plus petits (500-1500 tokens chacun)
- Définissez temperature=0.2 ou 0.3 pour la traduction
- Activez toujours stream=true pour une perception de vitesse bien meilleure
4. Problèmes de compte, de crédit et de cache
- Un solde très bas (quelques dollars) ou proche des limites → OpenRouter nettoie agressivement les caches et ajoute des vérifications supplémentaires, ralentissant chaque requête.
- Les heures de pointe (surtout le soir sur la côte ouest américaine) entraînent une charge globale plus élevée sur les fournisseurs populaires.
- Démarrage à froid lors des premières requêtes après connexion ou après une longue période d'inactivité (les caches se réchauffent après quelques appels).
Solutions :
- Maintenir au moins 10 à 20 $ de solde et activer le réapprovisionnement automatique.
- Envoyer quelques requêtes de "chauffage" au début d'une nouvelle session ou dans une nouvelle région.
- Éviter, si possible, d'exécuter des traitements par lots intensifs pendant les heures de pointe connues.
Liste de vérification pour une optimisation rapide
- Passer à un modèle rapide (Gemini 3 Flash recommandé en premier).
- Définir le routage par défaut sur Priorité de latence dans le tableau de bord.
- Activer le streaming + une faible température.
- Découper les textes longs et utiliser des appels parallèles.
- Maintenir un solde de crédit sain.
La plupart des utilisateurs constatent des améliorations majeures de vitesse en quelques minutes après avoir appliqué les 2 ou 3 premiers correctifs.
Conclusion
Le ralentissement de la traduction après connexion à OpenRouter est rarement causé par la plateforme elle-même. Dans la plupart des cas, il est dû au choix du modèle, aux paramètres de routage et aux habitudes de traitement par lots.
En passant à des modèles plus rapides et en configurant un routage priorisant la latence, vous pouvez obtenir des traductions 2 à 5 fois plus rapides tout en conservant une excellente qualité. Commencez avec Gemini 3 Flash et le changement de routage de latence — la différence est généralement immédiate.
Ouvrez votre tableau de bord OpenRouter maintenant, mettez à jour vos paramètres de routage par défaut et testez un modèle rapide sur votre prochaine tâche de traduction. Vous serez probablement surpris de la vitesse que vous pouvez atteindre.
Continue Reading
More articles connected to the same themes, protocols, and tools.
Qu'est-ce qu'OC Maker ? L'outil d'IA révolutionnant la création de personnages originaux en 2026
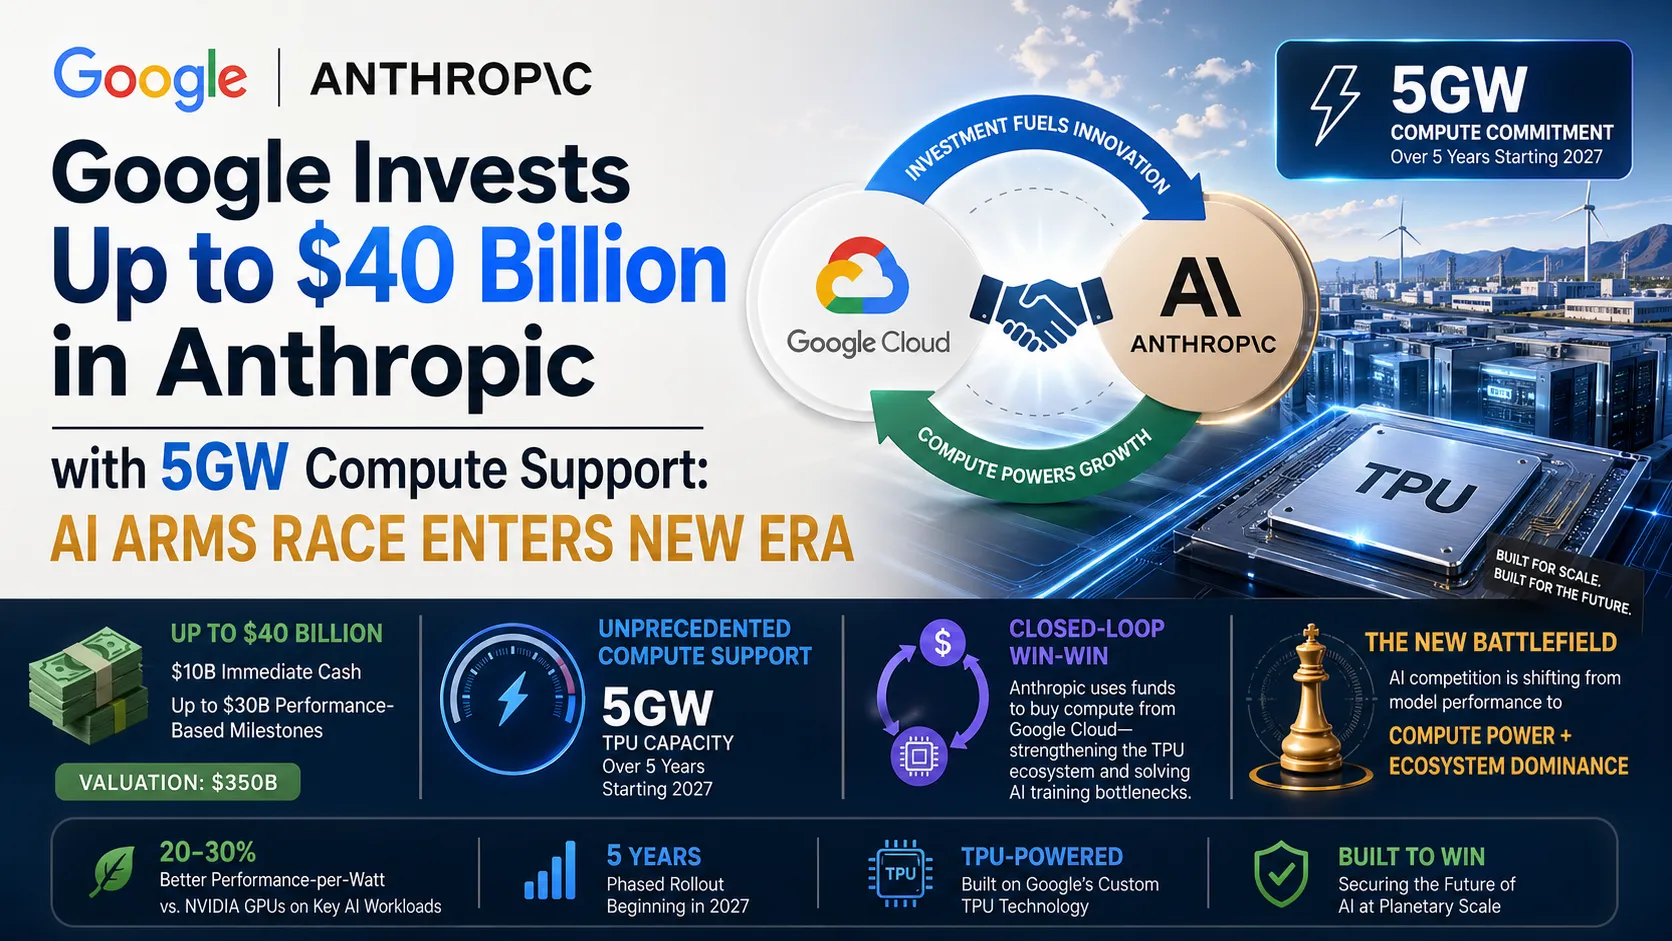
Google Investit Jusqu'à 40 Milliards de Dollars dans Anthropic avec un Soutien de 5 GW de Puissance Informatique : La Course à l'IA Entre dans une Nouvelle Ère
How to Use Claude Fable 5: Complete 2026 Guide to Anthropic’s Most Powerful Public AI Model
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
TinyFish
MCP ServersTinyFish est une plateforme d'infrastructure web pour les agents d'IA qui combine la recherche web en direct, l'extraction de contenu rendu par le navigateur, l'automatisation web basée sur des objectifs et des sessions de navigateur cloud gérées. Les développeurs peuvent accéder à la plateforme via des API, SDK, CLI et des intégrations avec des frameworks d'agents et des outils de codage IA.

FetchSandbox
MCP ServersFetchSandbox is a stdio MCP server and hosted API-sandbox service that lets AI coding agents import OpenAPI 3.x specifications, discover runnable workflows, and execute stateful integration tests without using production API credentials. It is designed for validating request flows, lifecycle state, webhooks, retries, and shareable run traces from MCP-compatible development tools.

GitHub Copilot Coding Agent
MCP ServersGitHub Copilot Coding Agent, now documented as Copilot cloud agent, is GitHub's asynchronous software development agent for researching repositories, planning changes, editing code on branches, and opening pull requests for review. It runs in a GitHub Actions-powered environment and can be started from GitHub, supported IDEs, GitHub CLI, the REST API, integrations, or the GitHub MCP Server.
viewmax mcp
MCP ServersViewMax MCP is a hosted Streamable HTTP MCP server for generating AI video, images, music, speech, and sound effects, with tools for model discovery, task polling, and credit checks. Official setup is documented for Claude Web/Desktop, Claude Code, Cursor, Codex, and SDK clients.