Andrej KarpathyがObsidianで動的な個人知識ベースを構築するためにLLMを活用する方法
主要ポイント
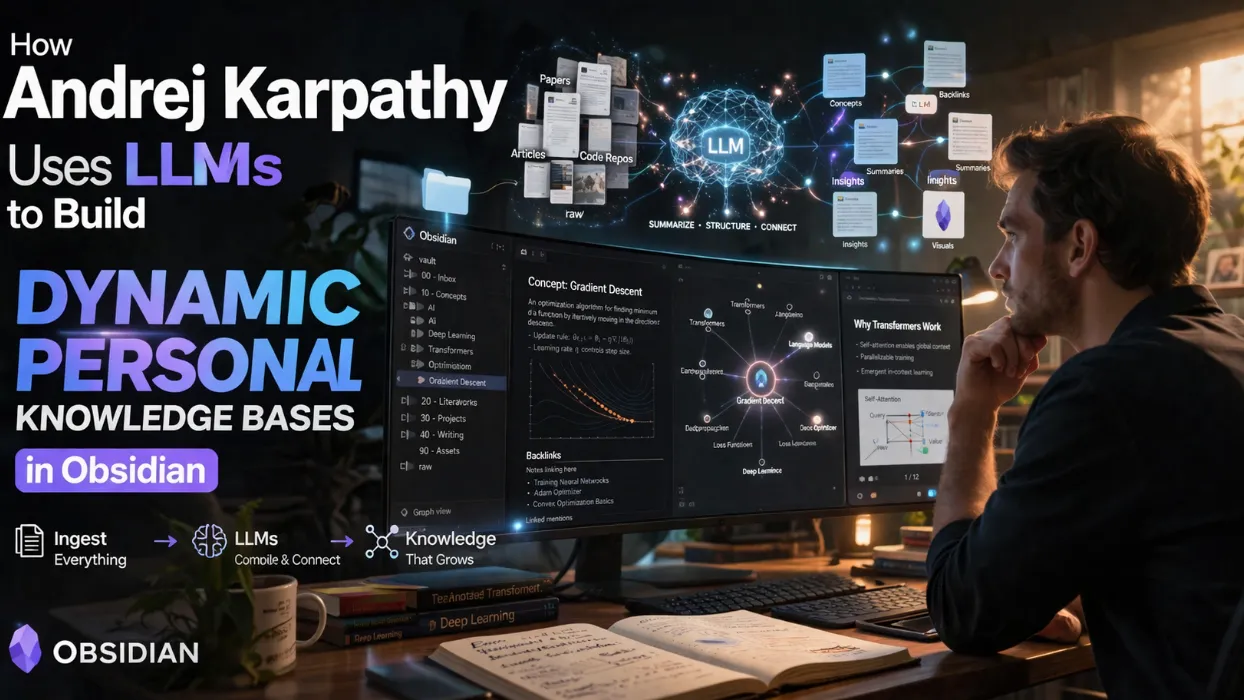
- Andrej Karpathyのシステムは、生の文書(論文、記事、リポジトリ、画像)を
raw/ディレクトリに取り込み、LLMを使ってそれらを段階的に構造化されたMarkdown wikiにコンパイルします。これには要約、バックリンク、概念記事、相互接続が含まれます。 - Obsidian は、生データ、コンパイルされたwiki、およびMarpスライドやMatplotlibプロットなどの生成された出力を閲覧する軽量フロントエンドとして機能し、LLMがほぼすべての執筆とメンテナンスを担当します。
- 大規模運用時(約100記事、約40万語)、複雑なQ&AがRAGへの依存を最小限に行われます。LLMは効率的なコンテキスト取得のためにインデックスと要約を自動維持します。
- LLMによるリンター・ヘルスチェック は、不一致を特定し、欠落データを補完し、接続を提案し、新しい記事を提案することで、データの整合性を確保します。
- 出力 はテキストを超えて、レンダリングされたMarkdown、スライド、視覚化、または動的HTMLにまで及び、多くの場合wikiに再びファイルされて知識が時間とともに複合的に増加します。
- コミュニティの応用例 には、汚染防止のためのエージェント分離、ファインチューニングのための合成データ、クエリごとに生成されるエフェメラルwikiなどの拡張が強調されています。
コードから知識操作へのシフト
分析は、トークン配分の根本的な変化を示しています:最近の最先端LLMは、純粋なコード生成よりも知識統合に優れています。Karpathyは、自身のトークン処理量の大部分が、一時的なターミナル出力ではなく、Markdownファイルや画像として保存された構造化された知識を操作することに費やされるようになったと報告しています。
このワークフローは、受動的な研究消費を能動的で自己改善型の知識ベースへと変革します。生のソースは専用ディレクトリに蓄積されます。その後、LLMがそれらを段階的に「コンパイル」します。要約の生成、内容を概念に分類、リンクされた記事の執筆、バックリンクの確立が行われます。
類似の個人システムのベンチマークは、wikiが臨界規模に達すると、検索オーバーヘッドの比例的な増加なしに、クエリの複雑さが劇的にスケールすることを示しています。
データ取り込みとコンパイルプロセス
パイプラインは対象を絞った収集から始まります:
- ソース処理:研究論文、記事、GitHubリポジトリ、データセット、および画像が
raw/に送られます。ウェブコンテンツはObsidian Web Clipper経由でMarkdownに変換され、画像はローカルにダウンロードされてLLMが直接参照できます。 - 段階的コンパイル:LLMは最初、新しい文書を一つずつ処理し、後にパターンマッチングで効率化します。「この新しい文書を私たちのwikiにファイルしてください」などの指示が、分類、要約、リンク付けをトリガーします。
- 構造作成:結果として生じるwikiの特徴:
- 文書ごとの要約
- 概念レベルの記事
- 双方向バックリンク
- ディレクトリベースの組織化
コミュニティのフィードバックによると、大規模な取り込みに対してはバッチ処理や多段階パイプラインがディレクトリ決定を改善しますが、Karpathyは品質のために初期段階は人間(ヒューマン・イン・ザ・ループ)が関与するようにしています。
Obsidian:理想的なフロントエンド
Obsidianは、このシステムにおける最小限の「IDE」として機能します:
- 生ソース、コンパイル済みwiki、および可視化を同時に表示
- Marpなどのプラグインにより、LLMが生成したMarkdownから直接スライドをレンダリング可能
- グラフ表示とバックリンクナビゲーションにより、創発的な関連性を発見
専門家たちは、ObsidianのローカルファーストMarkdown基盤がベンダーロックインを最小限に抑えつつ、カスタムツールをサポートすると指摘しています。VS CodeにMarkdown拡張機能を加えた代替案も存在しますが、Obsidianのエコシステムは視覚的・対話的探索を加速します。
コミュニティ実装では分離戦略が出現:生成コンテンツによる汚染を防ぐため、高品質の個人用ボールトと、エージェント向けの「雑然とした」ボールトを並行して維持する方法があります。
高度なQ&Aと出力生成
スケールアップ後、このwikiは洗練されたクエリをサポート:
- LLMは、自己管理されたインデックスと要約を活用して全文書コーパスをナビゲート
- 約40万語規模では、重いベクトルRAGなしに関連クラスターを効率的にコンテキストウィンドウが処理
- 出力はニーズに応じて適応:Markdownレポート、Marpスライドショー、Matplotlib図表、またはインタラクティブなフィルタリングと可視化のための動的HTML/JSまで
生成された成果物はしばしばwikiにフィードバックされ、探索が将来のクエリを強化する複利ループを形成します。Lex Fridmanらは、ポッドキャスト研究や一時的なミニwikiを介したオンザゴーの音声インタラクションに同様のセットアップを使用していると報告しています。
LLM駆動のリンティングとメンテナンス
特筆すべき機能は自動化された「ヘルスチェック」:
- 数週間隔で取り込まれたソース間の矛盾した主張を検出
- Web検索ツールを使用してギャップを補完
- 新規の関連性と候補記事を特定
- カバレッジを深めるフォローアップ質問を提案
これにより、wikiは静的なリポジトリから生きた研究パートナーへと変貌します。成長に伴い古いデータのリスクが高まりますが、バージョン管理された監査と漸進的更新は、単発的な取り込みよりもドリフトを効果的に緩和します。
新興ツールと将来の展望
ユーザーはコア機能を拡張:
- カスタムCLIや素朴な検索エンジンをツールとしてLLMに提供
- 合成データ生成とファインチューニングを組み合わせ、wiki知識をモデルの重みに埋め込む
- 一時的なwiki生成:単一クエリが、最終報告前に完全な、リント済みの、反復された知識ベースを生成 — 単純なデコードをはるかに超える
コミュニティで共有されるアーキテクチャ図は、取り込みからコンパイル、クエリ、強化までのステージを可視化します。非開発者向けにこれを橋渡しする製品は明確な機会を表しています。あらゆる組織が、コンパイルを待つ非構造化「raw/」データを維持しているからです。
従来のPKM(個人知識管理)との比較が利点を浮き彫りに:LLM自動化により、活発な研究領域での手動キュレーションが80-90%減少。一方、バックリンクとグラフは人間が見逃す可能性のある洞察を表面化させます。
課題とベストプラクティス
- 規模の管理: 要約は陳腐化する可能性があるため、新鮮な差分と監査を優先する。
- 汚染の防止: エージェントが生成したコンテンツは、検証されるまで隔離する。
- 段階的な導入: 小規模から始め、パターンが現れてから完全自律へ移行する。
- ツールの簡素化: フラットなMarkdownディレクトリと
AGENTS.mdスキーマで十分。過剰な設計は価値の実現を遅らせる。
実践的な洞察: 1つの研究トピックから始める。10〜20の情報源を収集し、LLMに初期ウィキの作成を指示。その後、クエリとリンターによる反復を実施。従来の検索・ノート取りと比較して、深いクエリと節約時間で価値を測定する。
結論
アンドレイ・カルパシーのLLM活用知識ベースワークフローは、研究者や実践者の情報との関わり方における実用的な進化を示している。コンパイル、維持管理、総合といった作業を能力のあるモデルに委任し、直感的なインタラクションにはObsidianを活用することで、ユーザーは摩擦を減らしながら深い理解を達成できる。
このアプローチは時間とともに効果が増幅する: 各クエリが知識基盤を強化し、各リンター実行が完全性を高める。フロンティアモデルが進歩するにつれ、自然な質問から一時的なウィキ全体を自動化する広範なツールが登場するだろう。
今日から最小限のバージョンを実装しよう——次に収集する研究資料を取り込み、LLMに基盤の構築を任せてみる。知識を消費する姿勢から積極的に育成する姿勢への転換は、エージェント化の時代における個人と組織の知性のあり方を再定義する可能性がある。
小さく始め、絶え間なく反復し、個人ウィキが真の知的乗数へと進化していく様子を観察しよう。
Continue Reading
More articles connected to the same themes, protocols, and tools.
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
PaidSync.ai
MCP ServersPaidSync.ai is a hosted MCP server for paid advertising that exposes 610+ tools across 14 advertising, analytics, tagging, and commerce platforms. It supports read/write workflows from AI clients including ChatGPT, Claude, Gemini, Cursor, Claude Code, and Codex, with a free plan.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.