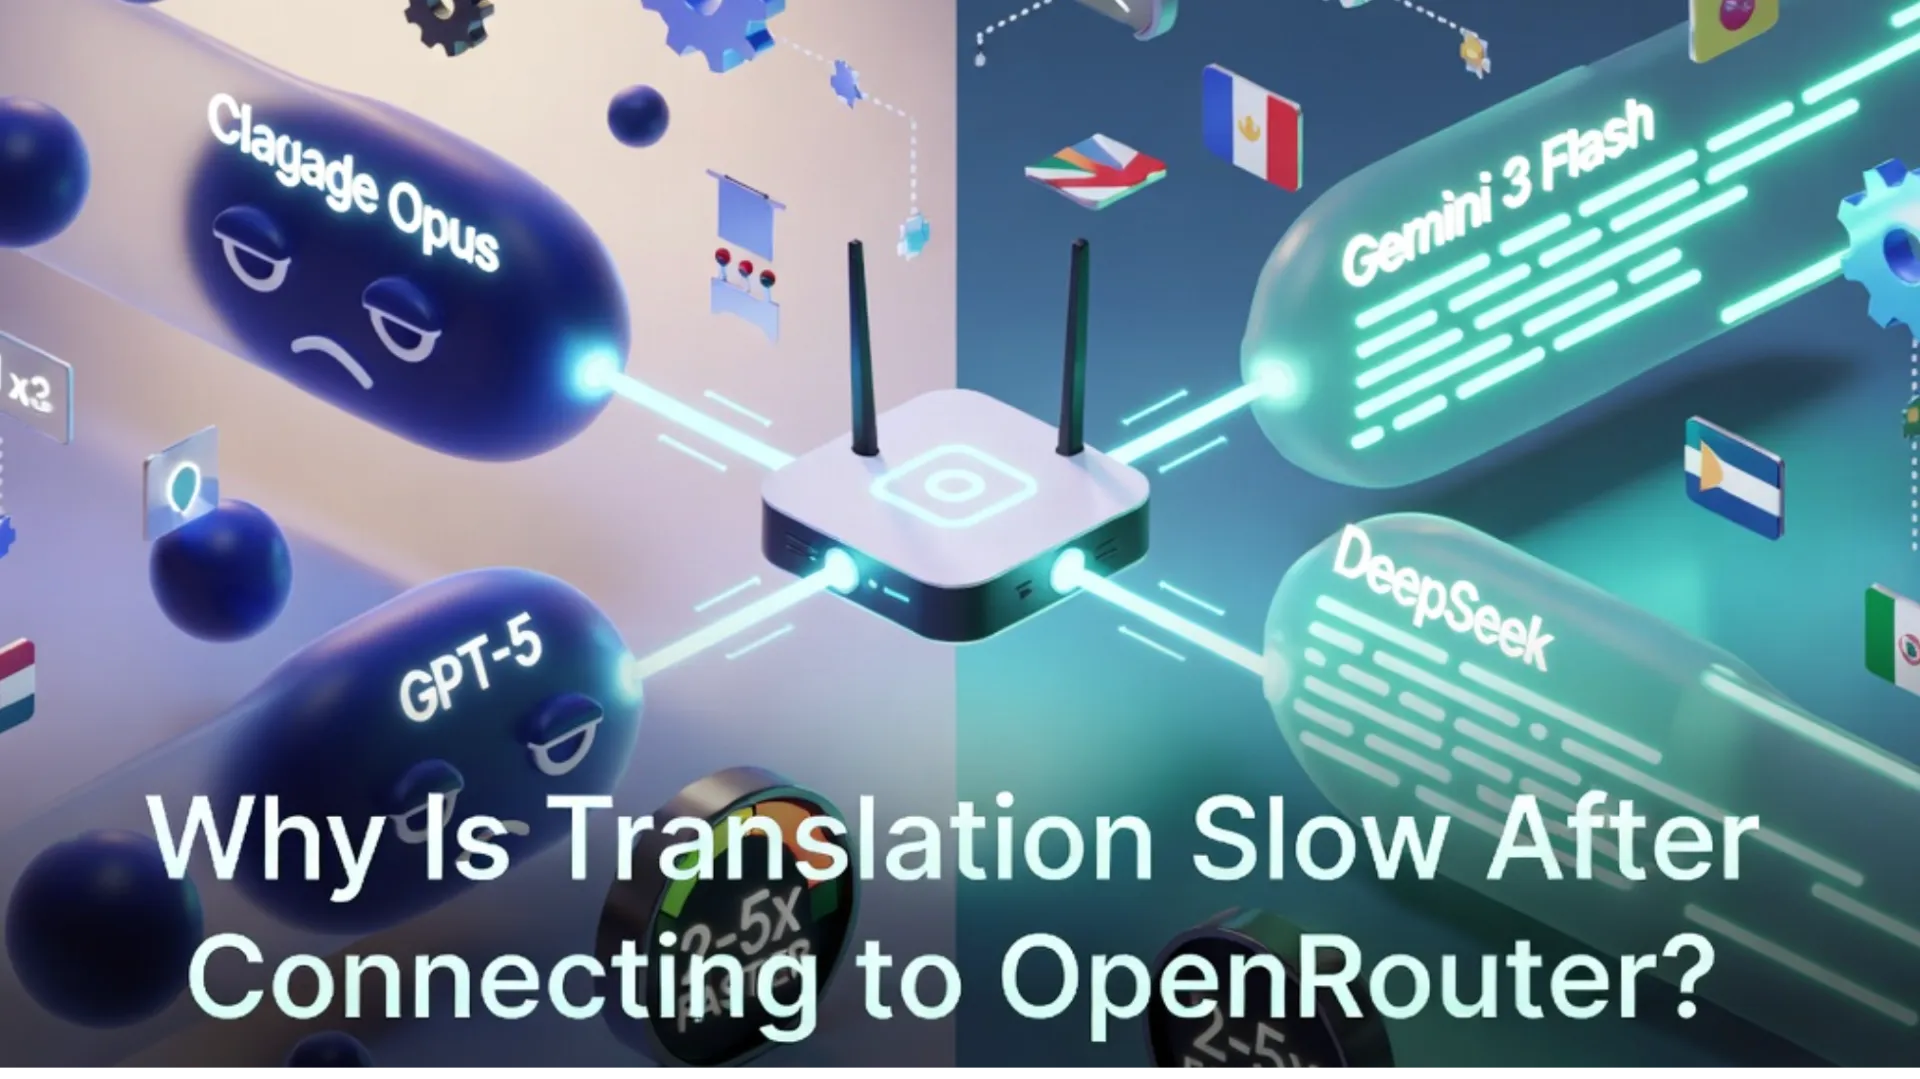
¿Por qué es lenta la traducción después de conectarse a OpenRouter? Principales causas y soluciones rápidas 2026
Puntos Clave
- La causa principal de traducciones lentas en OpenRouter es usar modelos inherentemente lentos (Claude Opus/Sonnet, clase GPT-5, Gemini Pro) en lugar de modelos rápidos.
- El enrutamiento por defecto prioriza el costo sobre la velocidad — cambiar a Latencia (más baja primero) a menudo ofrece una mejora inmediata.
- El manejo deficiente de lotes (llamadas en serie, sin streaming, prompts largos sin fragmentar, temperatura alta) es extremadamente común y fácil de solucionar.
- Un saldo de créditos bajo y una caché fría en las primeras solicitudes también contribuyen significativamente.
- Cambiar a modelos rápidos como Gemini 3 Flash, DeepSeek V3/V4, Qwen3 o Mistral Small puede hacer la traducción 2-5 veces más rápida manteniendo una buena calidad para la mayoría de casos de uso.
Principales Causas de Traducción Lenta en OpenRouter (Clasificadas por Frecuencia)
1. Usar un Modelo Lento (Causa Más Común)
Muchos usuarios se conectan a OpenRouter y siguen usando modelos de alta calidad pero lentos:
- Claude Opus / Sonnet 4.x: La mejor calidad, pero una inferencia significativamente más lenta, especialmente en textos largos. Cuanto más largo es el contexto, más obvia es la ralentización.
- Modelos Gemini Pro / clase GPT-5: Calidad excelente pero sufren de largas colas durante las horas pico.
Solución: Cambiar a modelos rápidos optimizados para velocidad:
- Gemini 3 Flash (o Flash Lite)
- DeepSeek V3 / V4
- Qwen3-235B
- Mistral Small
Estos modelos son típicamente 2-5 veces más rápidos en tareas de traducción y ofrecen una calidad suficiente para uso diario, documentos, novelas visuales y la mayoría del trabajo profesional.
2. La Estrategia de Enrutamiento por Defecto No Prioriza la Velocidad
Incluso con el mismo modelo, OpenRouter tiene múltiples proveedores backend. Por defecto, a menudo elige el proveedor disponible más barato, que puede ser más lento o tener una carga pesada.
Soluciones:
- En el Panel de OpenRouter → Configuración → Enrutamiento, cambiar Orden de Proveedor por Defecto a Latencia (más baja primero).
- En tu solicitud API, añade parámetros de enrutamiento:
json { "model": "google/gemini-3-flash", "provider": { "sort": "latency" }, "stream": true }
Esto obliga a OpenRouter a elegir el backend disponible más rápido para tu solicitud.
3. Procesamiento por Lotes Subóptimo (Muy Común)
- Llamar a traducciones en serie en lugar de en paralelo (sin ThreadPool o asyncio)
- Enviar prompts muy largos + documentos completos en una sola solicitud sin fragmentar
- Configuraciones de temperatura alta (la traducción funciona mejor en temperature=0.2~0.3)
- No usar streaming — el cliente espera toda la respuesta antes de mostrar algo
Soluciones:
- Usar procesamiento paralelo con asyncio o concurrent.futures
- Dividir textos largos en fragmentos más pequeños (500-1500 tokens cada uno)
- Configurar temperature=0.2 o 0.3 para traducción
- Activar siempre stream=True para una velocidad percibida mucho mejor
4. Problemas de Cuenta, Crédito y Caché
- Saldo muy bajo (unos pocos dólares) o cerca de los límites → OpenRouter limpia cachés de forma agresiva y añade comprobaciones extra, ralentizando cada solicitud.
- Horas punta (especialmente las noches en la costa oeste de EE. UU.) causan una carga global mayor en los proveedores populares.
- Arranque en frío en las primeras solicitudes tras conectarse o después de mucha inactividad (los cachés se calientan tras unas pocas llamadas).
Soluciones:
- Mantener un saldo de al menos $10–20 y habilitar la recarga automática
- Enviar unas pocas solicitudes de calentamiento al iniciar una nueva sesión o en una nueva región
- Evitar ejecutar lotes pesados durante las horas punta conocidas, si es posible
Lista de Verificación para Optimización Rápida
- Cambiar a un modelo rápido (se recomienda primero Gemini 3 Flash)
- Establecer el enrutamiento predeterminado como Prioridad de Latencia en el panel de control
- Habilitar streaming + baja temperatura
- Fragmentar textos largos y usar llamadas paralelas
- Mantener un saldo de crédito saludable
La mayoría de los usuarios ven mejoras importantes de velocidad en minutos tras aplicar las 2-3 primeras soluciones.
Conclusión
La ralentización de la traducción tras conectarse a OpenRouter rara vez es causada por la plataforma en sí. En la mayoría de los casos, se reduce a la elección del modelo, la configuración de enrutamiento y los hábitos de procesamiento por lotes.
Al cambiar a modelos más rápidos y configurar el enrutamiento con prioridad de latencia, puedes lograr traducciones de 2 a 5 veces más rápidas manteniendo una excelente calidad. Comienza con Gemini 3 Flash y el cambio de enrutamiento a latencia: la diferencia suele ser inmediata.
Abre ahora tu panel de control de OpenRouter, actualiza la configuración de enrutamiento predeterminado y prueba un modelo rápido en tu próxima tarea de traducción. Es probable que te sorprendas de lo rápido que puede ser.
Continue Reading
More articles connected to the same themes, protocols, and tools.
¿Qué es OC Maker? La Herramienta de IA que Revoluciona la Creación de Personajes Originales en 2026
Google invierte hasta $40 mil millones en Anthropic con soporte de computación de 5GW: la carrera armamentística de la IA entra en una nueva era
Acceso No Autorizado al Anthropic Mythos AI: Cómo un Grupo de Discord Infringió el Modelo de Ciberseguridad 'Demasiado Peligroso'
Referenced Tools
Browse entries that are adjacent to the topics covered in this article.
Hyper3D MCP
MCP ServersHyper3D MCP is Hyper3D's hosted Rodin MCP server for creating 3D assets from natural-language instructions or supported references, checking asynchronous generation progress, and retrieving model download links inside AI coding clients. Official setup is documented for Codex, Claude Code, and Kimi Code CLI.